# 一、高性能
# 1.1 传输优化
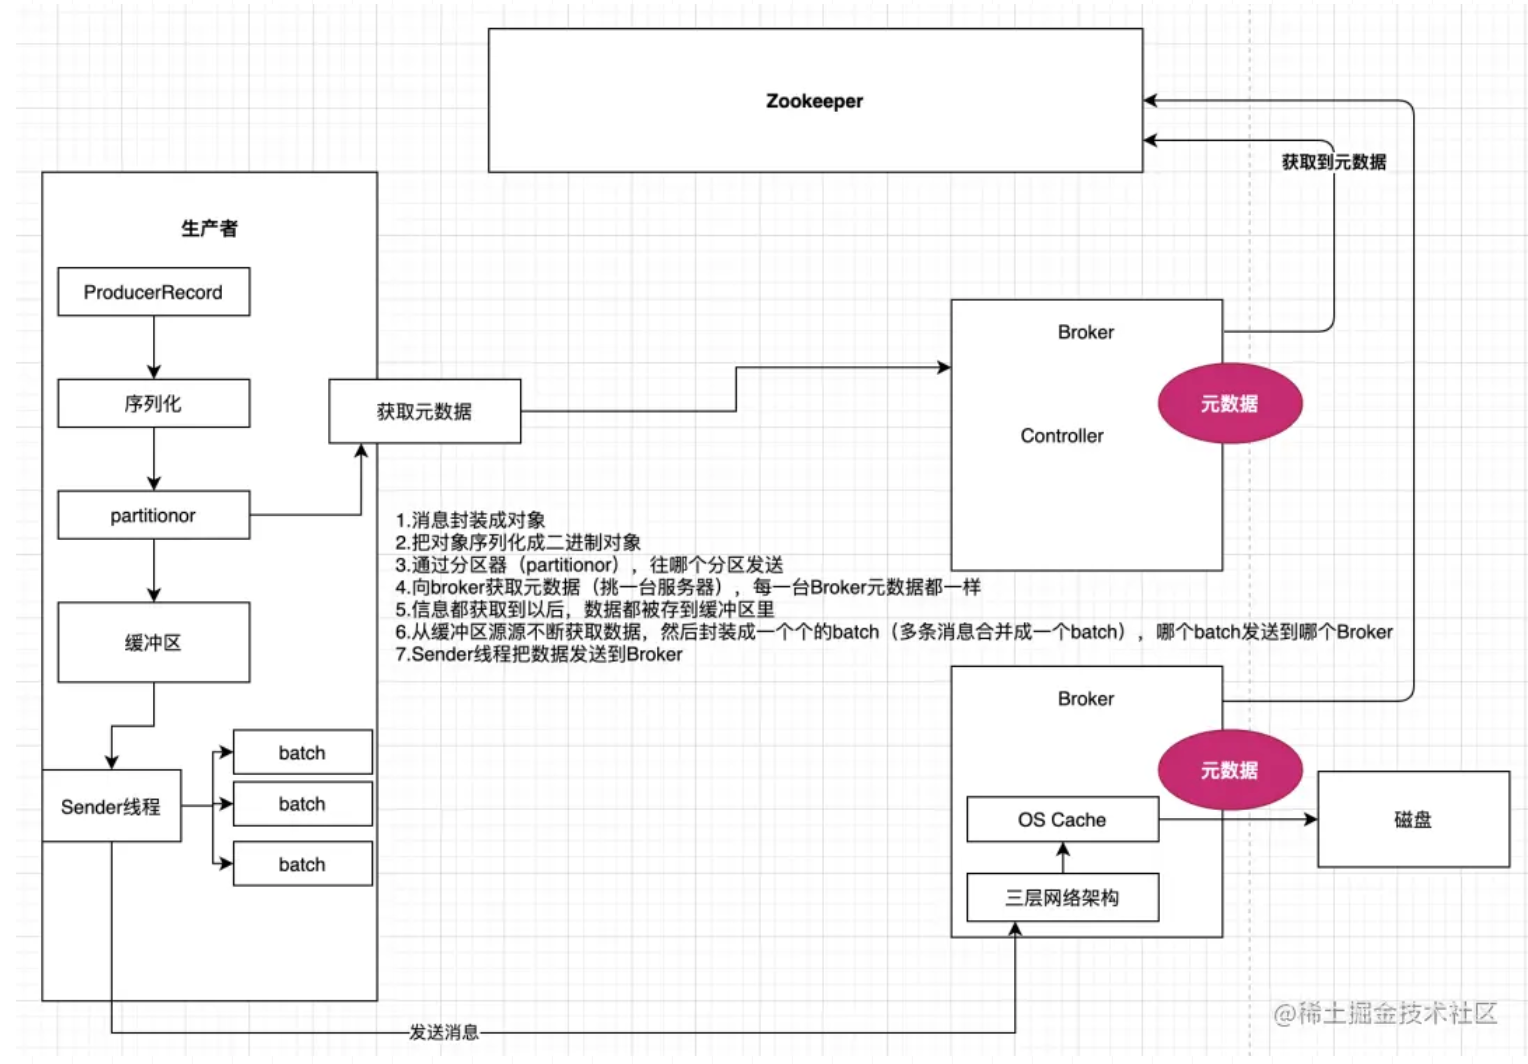
消息压缩
kafka的producer在发送消息的时候,可以通过
compression.type开启压缩机制,如lz4压缩,压缩后可以减少数据量,提升吞吐量及传输效率,但是会加大producer端端CPU开销,是一种以时间换空间的机制,默认情况下是关闭的。
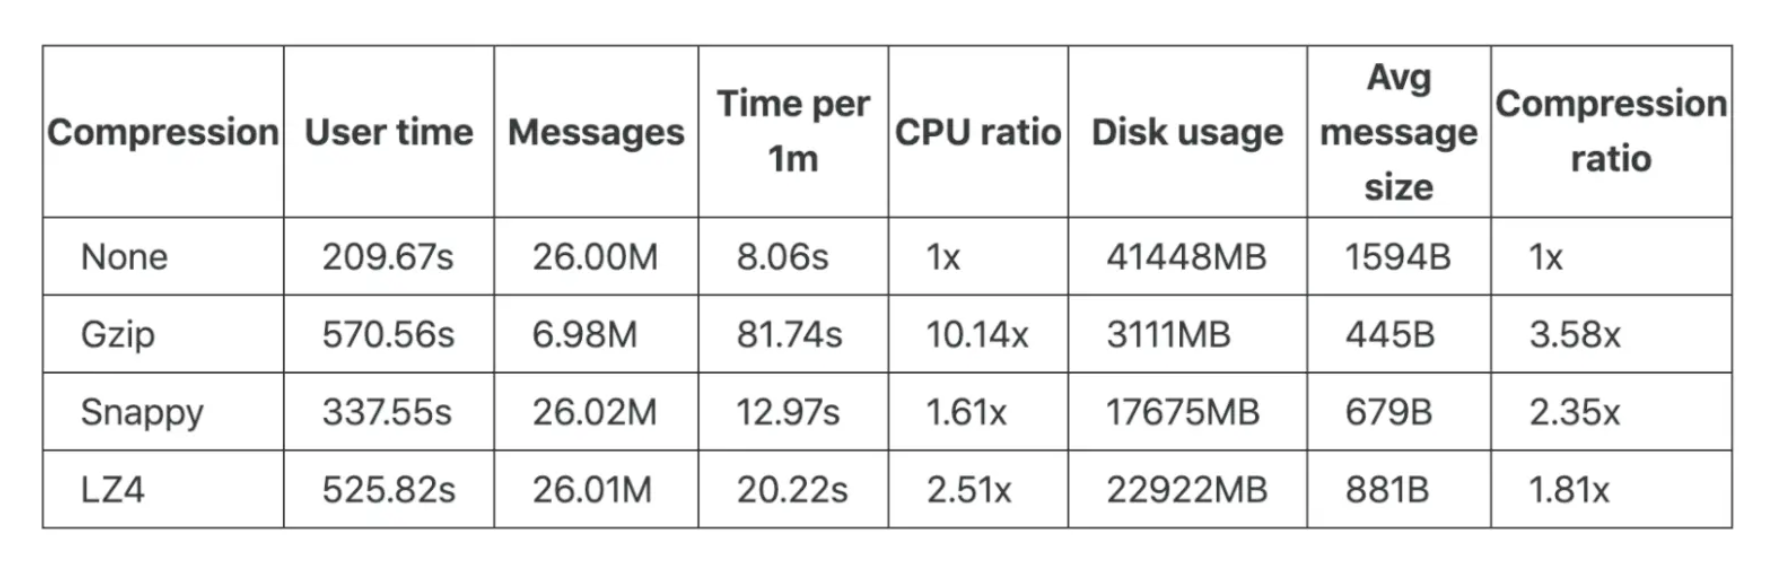
批量发送
kafka提供了批量发送机制,通过
buffer.memory(默认值是32M)在producer端创建缓冲区,并且通过batch.size(默认大小是16k)设置每个批次的数据量大小。如果batch太小,会导致频繁网络请求,吞吐量下降;如果batch太大,会导致一条消息需要等待很久才能被发送出去,而且会让内存缓冲区有很大压力,过多数据缓冲在内存里。在生产环境中,通常会调高batch值以提高吞吐量,而为了避免由于batch值太大而导致消息发送延迟,还会结合
linger.ms(默认为0)参数,配置至少每隔一段时间发送一次,比如100ms,那么100ms内如果batch size达到16k则会发送,否则则100ms到了就发送一次。应该数据会被Partition到不同的分区,不同的分区又在不同的Broker,所以可以存在多份Batch数据。
# 1.2 分区机制
Kafka中同个Topic可以存在多个Partition,不同的Partition可以存放在不同的Broker上,Partition又分为主从分区,主分区负责读写,从分区会定时同步主分区的数据,并且在主分区宕机的时候,通过Controller从从分区中选举出新的主分区。
分区机制可以简单的认为是在不同的Broker上建立了多个队列,大大提高了并发性能,不同的partition可以又消费者组的不同消费者并行消费。存入的数据又分区策略决定,常见的分区策略有三种:随机分区、顺序分区、按PartitionKey分区。
# 1.3 零拷贝
Kafka采用了零拷贝技术,在操作系统上采用发送sendfile()指令的方式,将内核缓冲区的数据直接拷贝到内核的socket缓冲区,避免了数据拷贝到用户缓冲区,减少CPU拷贝次数,减少上下文切换,减少系统资源消耗,提高IO性能。
# 1.4 顺序磁盘写入
Kafak磁盘写入性能高,主要由下面两个因素决定:
- 追加写:Kafka是以二进制文件的方式存储消息的,而文件的写入采用了文件追加的方式写入数据,这种写入方式大大减少了磁盘寻址带来的性能消耗
- 页缓存(PageCache):在写入的时候,先写入页缓存,再由操作系统刷入磁盘,避免了频繁磁盘写入导致性能降低。在读取的时候,PageCache具有预读的功能,会预先读取后序的部分数据,而由于消息是以顺序写入的,所以能够最大程度的使用到预读功能。
# 二、高可用
# 2.1 副本机制
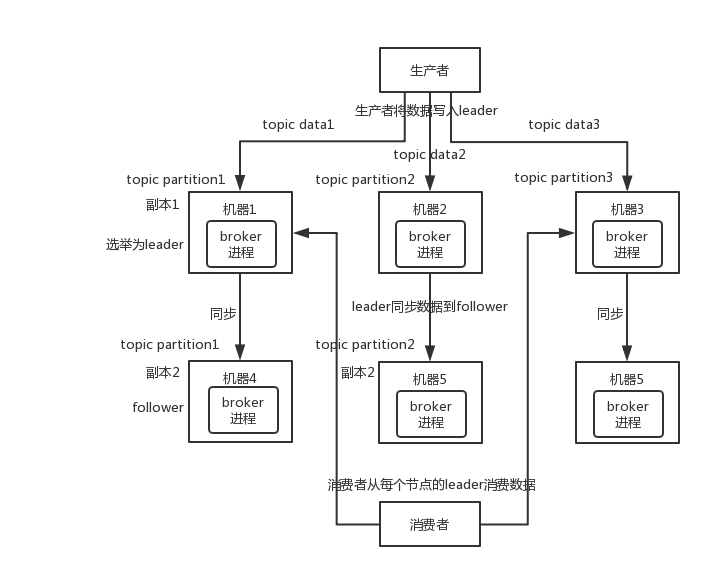
Kafka是天然的分布式消息队列,一个topic的数据是分区分散存储在不同Broker上的,每个机器存放一部分数据,可以认为每个Partition就是一个Queue。而RabbitMQ则并不是分布式队列,其队列数据都存放在一个节点上,只不过提供了集群模式(主从),提高其高可用性而已。
如下图所示,Kafka提高了副本机制,即主从模式,主节点负责消息的读写,从节点负责定时从主节点pull数据,如果
ack=all,则从节点同步完数据后会回复ack给主节点,主节点收到所有从节点的ack后才返回ack给生产者,表示写入成功。
# 2.2 Zookeeper 主从切换
ZAB理论
Zookeeper在CAP模型中属于CP模型,强调的是强一致性。
选举机制
# 2.3 Controller选举
Controller通过Zookeeper实现选举功能,当Broker加入集群后,会尝试去Zookeeper的Controller节点下创建临时节点,创建成功则说明成为Controller,否则则说明选举失败。除了Controller的其他Broker也会通过watch监听Controller节点,如果Controller掉线导致临时节点被删除,则会尝试竞选Controller。
Controller的职责如下:
- Broker管理:通过监听Broker节点,如果有新的Broker接入,则拉取数据并通知到其他Broker,如果有Broker掉线,则需要重新选举掉线的Broker上的Leader。
- Topic/分区管理:通过监听Topic节点,如果有新的节点在Zookeeper创建,则根据将其分区创建在Broker上。
Controller选举的脑裂问题:
如果由于网络问题到值短暂的掉线,新的Controller被选举,而网络恢复后,旧的Controller又存活,那么就存在两个Controller,导致脑裂问题,Kafka提供了epoch number(类似于版本号),该值存放于Zookeeper中,每次新的Controller被选举都会递增,当其他Broker接收到比该值小的消息后,会直接将其丢弃。
# 2.4 Leader选举
大数据中Leader的选举算法有很多,常用的有以下两种:
- 通过Zookeeper选举,所有Leader创建ZNode节点,其Follower节点通过watch监听该节点,当宕机时进行选举,这种模式会有以下两个问题:
- split-brain (脑裂)
- herd effect (羊群效应):如果宕机的Broker存在大量Partition,那么可能导致网络堵塞
- Zookeeper负载过重,每个节点都要注册一个watch
- 通过Controller选举(当前Kafka的选举模式),选举过程如下:
- 从zk中读取当前分区的所有ISR(in-sync-replicas)集合
- 调用配置的分区算法选择分区的leader
- NoOpLeaderSelector
- OfflinePartitionLeader
- ReassignedPartitionLeader
- PreferredReplicaPartitionLeader
- ControlledShutdownLeader
分区宕机分为以下两种:
- 少部分分区宕机(Leader):当leader宕机了,会从follower选择⼀个作为leader。当宕机的重新恢复时,会把之前commit的数据清空,重新从leader⾥pull数据。
- 全部分区节点宕机:Kafka提供了两种恢复机制,第一种可以保证数据一致性,但是可用性降低,第二种牺牲一致性保证其可用性。
- 等待ISR中的⼀个恢复后,并选它作为leader。(等待时间较⻓,降低可⽤性)
- 选择第⼀个恢复的副本作为新的leader,⽆论是否在ISR中。(并未包含之前leader commit的数据,因此造成数据丢失)
# 三、高可靠
MQ 有个基本原则,就是数据不能多一条,也不能少一条。
- 不能多:重复消费和幂等性问题
- 不能少:消息丢失问题
高可靠即保证消息不丢失,消息的丢失主要在以下几个过程,针对以下几个过程,Kafka提供了对应的机制去处理消息丢失问题,如ACK机制、持久化机制、副本机制。
- 消息在传输过程丢失(网络问题)
- MQ接收到消息并存在缓存中,机器宕机导致数据丢失
- MQ接收到消息并持久化到磁盘,服务器磁盘损坏导致数据丢失
- 消费者消费消息,由于业务处理时异常导致消息处理失败,而MQ消息offset已经被提交,导致消息丢失
# 3.1 ACK机制
消费者端丢失数据
问题:Kafka默认offset是自动提交的,当消费者拉取消息并自动提交了offset,如果此时消费者挂掉或者重新部署,那么会导致消息丢失,因为此时消费者中的数据是存放在内存中的。
解决:关闭自动提交offset,改用手动提交,即当业务处理完之后再手动提交,但是这种会导致另一个问题,即消息的重复消费,如果我们如理完业务后,还没来得及手动提交offset,此时服务挂掉,那么重启后会重复消费上个消息,所以需要做幂等性处理。
# 3.2 持久化机制
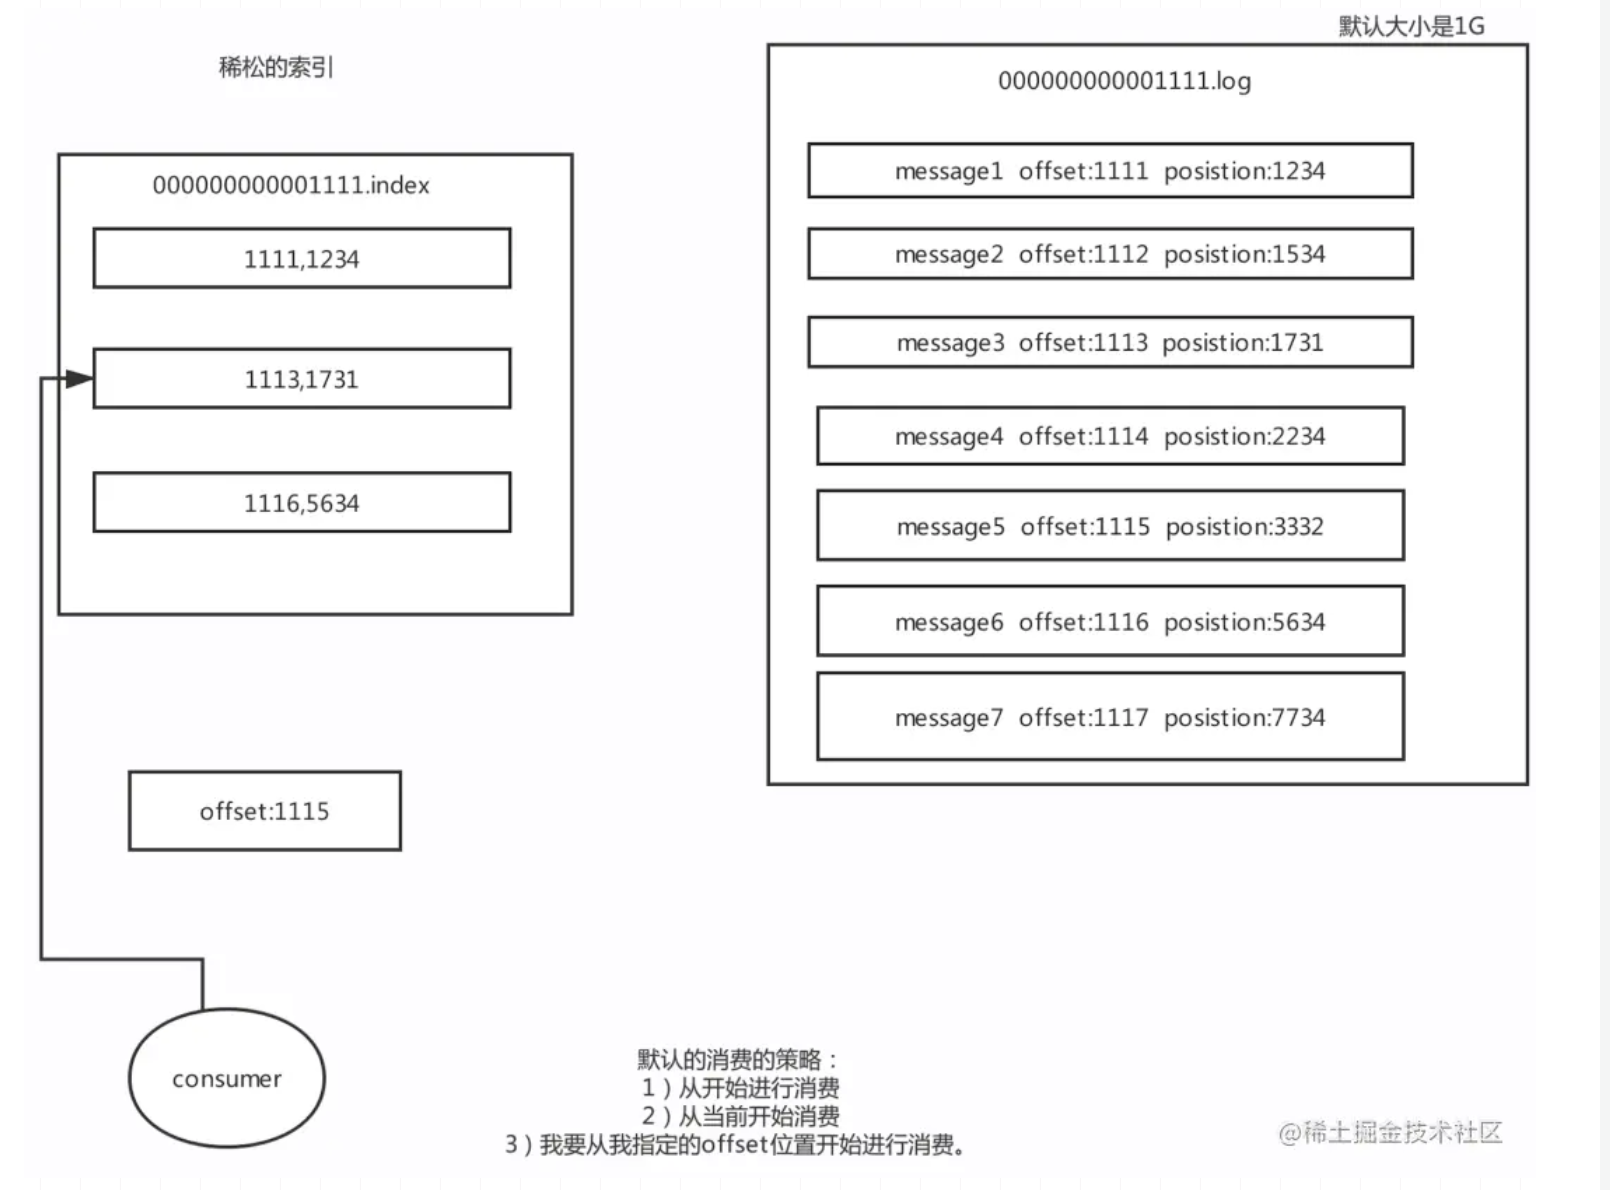
Kafka中以日志文件的方式存储消息,比如创建了一个
topic_a,然后创建的时候指定了这个主题有三个分区,那么Kafka在创建的时候会在三个Broker上分别创建目录,比如第一个Broker上创建topic_a-0目录,该目录下有
- log文件:存放消息数据,默认大小是1G,满1G则新建一个log文件。
- index文件:存放索引文件,Kafka每写入4k大小的日志(log),就忘index中写入一个记录索引,查找的时候采用二分查找。
# 3.3 副本机制
Kafka提供了分区副本机制,创建主题时,可以指定分区,也可以指定副本个数。
- 写数据、读数据操作都是从leader partition去操作的,follower partition负责数据同步备份。
- Kafka为每个Topic维护一个ISR(in-sync- replica)列表,ISR中即存放了跟主分区保持数据同步的从分区,当主分区宕机时,由Controller从ISR中选择一个分区作为主分区(leader partition选举)。