# 一、五大数据结构
# String
(缓存统计数据,提高读性能)
Redis的字符串类型的全称是 Simple Dynamic Strings 简称 SDS(简单动态字符串),底层数据结构称为SDS对象,包括了整形和字符串,底层采用int、emstr、raw三种数据结构分别对不同长度的字符串申请相应的存储类型,从而有效的节约了空间。常用于页面缓存和整数、浮点类型的存储和计算。
- int:整型数据
- emstr:字符串并且长度小于44字节
- raw:字符串并且长度大于44字节
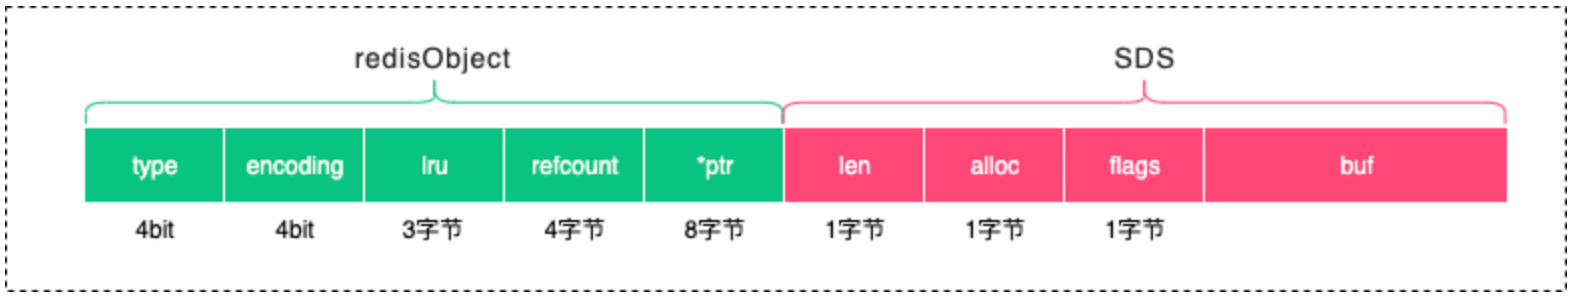
Redis中每个对象都会包含一个redisObject 对象头,该对象头结构如下:
// 总共占用16bytes
typedef struct redisObject {
unsigned type:4; // 4 bit,对象的数据类型
unsigned encoding:4; // 4 bit,对象的数据编码
unsigned lru:LRU_BITS; // 3 个字节,最近最少使用信息,内存回收时会用到
int refcount; // 4 个字节,引用计数器
void *ptr; // 8 个字节,对象指针,指向具体的内容
} robj;
2
3
4
5
6
7
8
除了redisObject对象头外,SDS对象还包含自己的数据结构,包括已使用长度、总长度等属性,减完用于存储数据的内存就剩下44bytes。
常用场景:
- 页面数据缓存:减少数据库操作,提供性能
- 数字计算与统计:原子性操作
- 共享数据:如Session共享
- 分布式锁:原子性set
常用的指令:
- set k1 1000 val1
- incrby k3 5:对k3的值+5
- incr k1:对k1对值自增
# 字典
字典类型 (Hash) 又被成为散列类型或者是哈希表类型,它是将一个键值 (key) 和一个特殊的哈希表关联起来,这个哈希表表包含两列数据:字段和值。哈希表底层是基于数组+链表的数据结构实现,数组用于存储元素,链表用于处理哈希冲突。
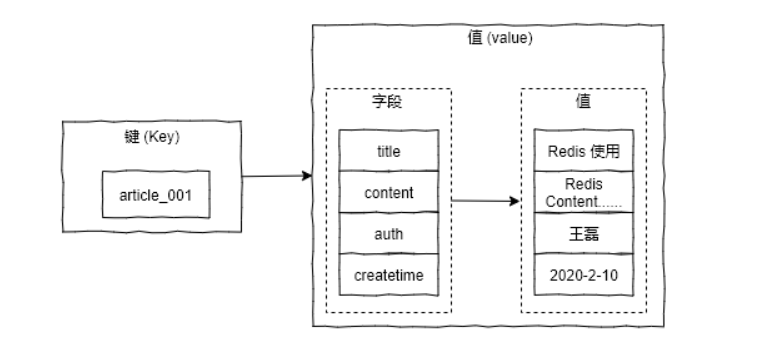
Redis中的字典底层基于哈希表实现
- ht:包含两个哈希表h0和h1,h1只有在rehash的时候被分配空间使用。
- dicht:
- table:哈希表包含key和value,底层采用数组+链表的方式进行存储,数组用于哈希索引查找元素存储,链表用于解决哈希冲突问题。
- size:当前的哈希表中的大小
- sizemask:用于哈希计算下标索引
- used:当前的元素大小
- dicht:
- rehashidx:记录当前rehash的下标,-1表示没有开启rehash,其他表示正在rehash
渐进式扩容:
由于Redis是采用单线程进行任务处理的,如果同时大数据量的字典的rehash,会导致服务很长时间无法提供服务,为了避免这种情况的发生,Redis采用渐进式rehash的方式。当需要进行扩容操作时,为h1分配内存空间,并且将字典的rehashidx置为0,增量式的将h0的元素rehash到h1,每完成一个rehashidx+1,直到所有元素都被rehash到h1中。在此过程中,get操作会在h0和h1之间进行查找,put操作会直接put到h1,当完成h0的rehash后,将h0指向h1,将h1置为null。该思想类似于写时复制的思想,例如Java中的CopyOnWriteArrayList。
源码:(dict.c)
int dictExpand(dict *d, unsigned long size)
{
 /* 需要的容量小于当前容量,则不需要扩容 */
 if (dictIsRehashing(d) || d->ht[0].used > size)
     return DICT_ERR;
 dictht n;
 unsigned long realsize = _dictNextPower(size); // 重新计算扩容后的值
 /* 计算新的扩容大小等于当前容量,不需要扩容 */
 if (realsize == d->ht[0].size) return DICT_ERR;
 /* 分配一个新的哈希表,并将所有指针初始化为NULL */
 n.size = realsize;
 n.sizemask = realsize-1;
 n.table = zcalloc(realsize*sizeof(dictEntry*));
 n.used = 0;
 if (d->ht[0].table == NULL) {
     // 第一次初始化
     d->ht[0] = n;
     return DICT_OK;
 }
 d->ht[1] = n; // 把增量输入放入新 ht[1] 中
 d->rehashidx = 0; // 非默认值 -1,表示需要进行 rehash
 return DICT_OK;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
常用场景:
- 存储用户信息
- 存储用户购物车信息
- 存储服务区的基础信息
# List
Redis中的List结构是一个有序链表,底层采用**ziplist(压缩列表)和quicklist(快速列表)**实现,当元素比较少的时候,采用ziplist存储,ziplist会开辟一块连续的内存块,减少元素前后指针带来的内存消耗。如果元素比较多,则采用将ziplist转化为qickklist并采用双向链表存储,而qucklistNode本质上就是一个ziplist。
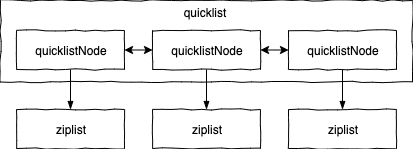
ziplist结构
- zlbytes:压缩列表字节长度,占 4 字节
- zllen:压缩列表的元素个数
- entryX:压缩列表存储的所有元素,可以是字节数组或者是整数
- zlend:压缩列表的结尾,占 1 字节

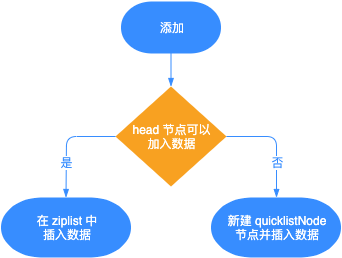
quicklist添加元素的过程:
我的理解是,会先判断当前是否为ziplist存储,如果是就在头节点插入,否则创建新的quicklistNode插入。
常用场景:
- 消息队列:lpush、rpop可以实现左进右出
- 文章列表:对于博客站点来说,当用户和文章都越来越多时,为了加快程序的响应速度,我们可以把用户自己的文章存入到 List 中,因为 List 是有序的结构,所以这样又可以完美的实现分页功能,从而加速了程序的响应速度。
常用指令:
- 查找指定区间元素:lrange key start stop(-1代表到结尾)
- 从链表左边添加元素:lpush key value1
- 从链表右边取出元素:rpop key
# SortedSet
SortedSet是一个有序集合,其存储元素相当于由两个值组成的,一个是集合的元素值,一个是排序值。有序集合ZSet底层采用 ziplist(压缩链表)或字典(哈希)+ zskiplist (跳跃表) 组成的。元素数量小于128并且长度都小于64字节,则采用压缩链表,否则采用字典+跳跃表。与Java中的HashMap的链表转红黑树的思想类似,n值比较小时以时间换空间,因为时间可控,n大于某个阈值,则采用空间换时间策略。
压缩链表:ziplist (opens new window)是一个经过特殊编码的双向链表,它的设计目标就是为了节约内存,但是查找需要顺序查找,即时间复杂度为O(n)。
字典表:key-vale对应obj-score,查找某元素的排序的时候,可以先通过字典表查找到score,再通过跳表查询对应的元素。
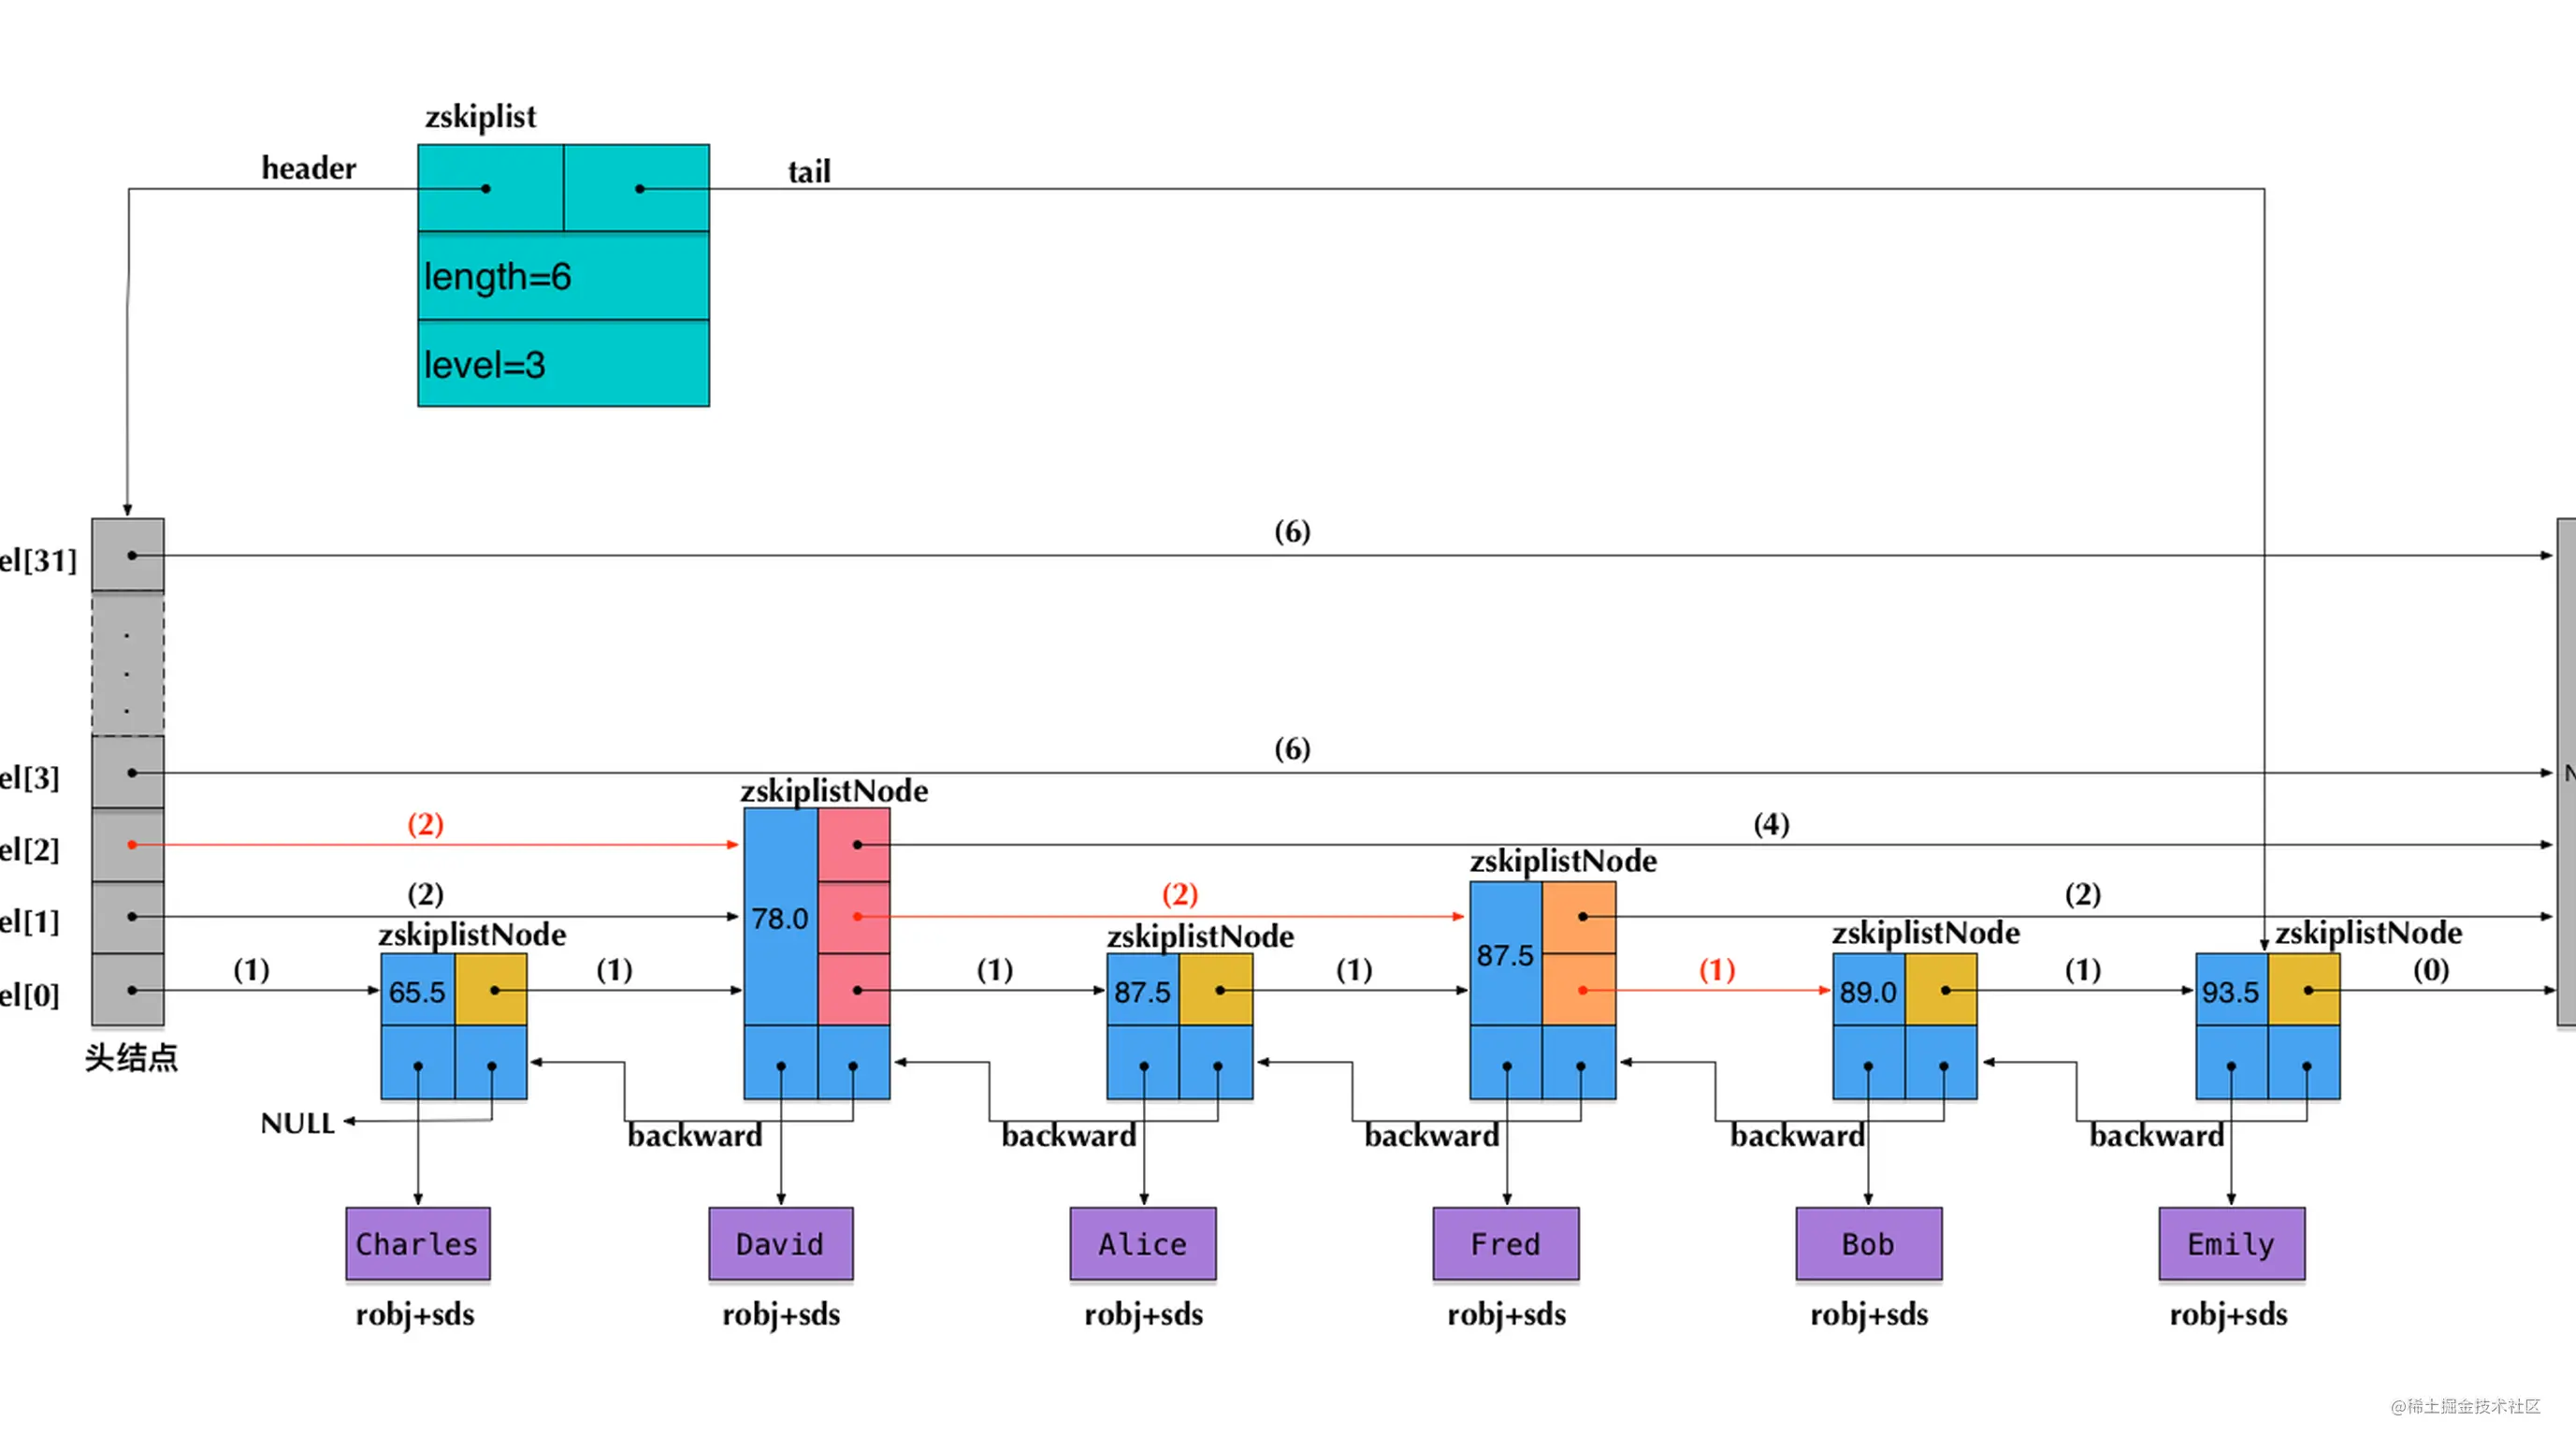
跳表:zskiplist包含头指针和尾指针zskiplistNode,分别指向元素头节点和尾节点,并且包含length和level属性。
- length属性:元素个数
- level属性:该跳表最大的层数
- zskiplistNode:即元素,zskiplistNode包含object、score及level数组,每个元素生成的时候会根据Redis提供的算法随机生成level,level即元素的层数(比如7即代表该元素在1-7层),各个层数通过指针形成单向链表。在Redis中level的最大长度为32
// level随机生成算法如下,从概率学上,其保证了产生越高的层数概率越低,保证平均时间为log(n)
MaxLevel = 32
p = 0.25
randomLevel()
    level := 1
    // random()返回一个[0...1)的随机数
    while random() < p and level < MaxLevel do
        level := level + 1
    return level
1
2
3
4
5
6
7
8
9
skiplist(跳表)的实现原理:
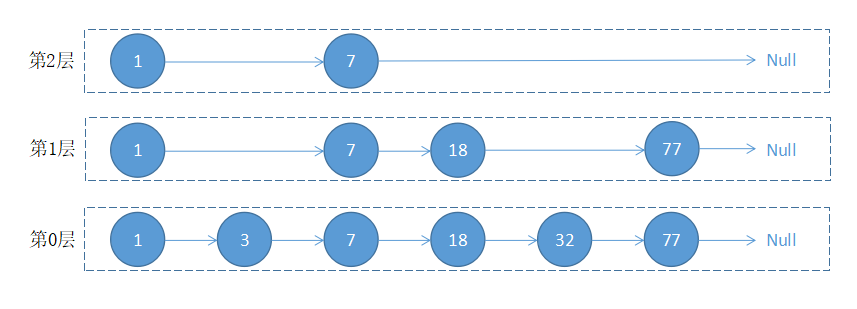
跳表是一种可以进行二分查找的有序链表,底层实现是在原有的有序链表上面增加了多级索引,通过索引来实现快速查找,其查找、插入、删除的时间复杂度都为log(n),因为需要维护索引。跳表的特点是效率高、实现简单。查找过程是从上层索引往下查找,每次都找到最后一个小于查找值的元素,然后往下级索引查找,直到找到元素。在Redis中,有序集合中对socre进行排序存储,涉及到对有序列表的查询,故采用跳表。
Redis为什么用skiplist而不用平衡树?(来自Redis的作者)
- 内存占用上跳表更可控,可以通过设置maxlevel控制索引层数。
- 性能上跳表拥有跟其他平衡树类差不多的性能。
- 实现难度上跳表逻辑及实现更加简单。
常用的应用场景:
- 学生成绩排名
- 粉丝列表,根据关注的先后时间排序
常用的指令有:
- 添加元素:
zadd key 5 redis 10 java - 查找区间元素:
zrange key minscore maxscore - 查找元素排序(索引):
zrank key redis - 查找元素分数:
zscore key redis
# Set
Set是一个无序集合,其存储的元素都是唯一的,不会有重复元素。Set底层采用intset (整数集合) 或 字段表 (普通哈希表) 进行存储,只有在元素都为整数,并且元素数量小于512的时候使用intset,其他的采用HashTable(key为值,value为null)。
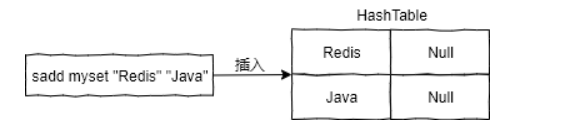
insert和hashtable的区别 (opens new window):inset底层采用有序整数存储,时间复杂度上查找元素为logn(二分查找),增加和删除为On(需要移动元素),而hashtable都是O1,时间上hashtable快于inset,而空间上inset优于hashtable(key-value存储,value为null),所以inset是一种时间换空间的结构。
源码:(t_set.c)
/*
 * 添加元素到集合
 * 如果当前值已经存在,则返回 0 不作任何处理,否则就添加该元素,并返回 1。
 */
int setTypeAdd(robj *subject, sds value) {
    long long llval;
    if (subject->encoding == OBJ_ENCODING_HT) { // 字典类型
        dict *ht = subject->ptr;
        dictEntry *de = dictAddRaw(ht,value,NULL);
        if (de) {
            // 把 value 作为字典到 key,将 Null 作为字典到 value,将元素存入到字典
            dictSetKey(ht,de,sdsdup(value));
            dictSetVal(ht,de,NULL);
            return 1;
        }
    } else if (subject->encoding == OBJ_ENCODING_INTSET) { // inset 数据类型
        if (isSdsRepresentableAsLongLong(value,&llval) == C_OK) {
            uint8_t success = 0;
            subject->ptr = intsetAdd(subject->ptr,llval,&success);
            if (success) {
                // 超过 inset 的最大存储数量,则使用字典类型存储
                if (intsetLen(subject->ptr) > server.set_max_intset_entries)
                    setTypeConvert(subject,OBJ_ENCODING_HT);
                return 1;
            }
        } else {
            // 转化为整数类型失败,使用字典类型存储
            setTypeConvert(subject,OBJ_ENCODING_HT);

            serverAssert(dictAdd(subject->ptr,sdsdup(value),NULL) == DICT_OK);
            return 1;
        }
    } else {
        // 未知编码(类型)
        serverPanic("Unknown set encoding");
    }
    return 0;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
常见的应用场景有:
- 用户标签:可以基于
sunion指令获取用户间的共同爱好 - 抽奖系统:set可以存储不重复的人员,通过
spop key nums可以随机抽取并移除三名人员,srandmember key nums则是随机抽取三人,但是不移除。
常用的指令有:
- 交集:
sinter - 并集:
sunion - 错集:
sdiff
# 二、特殊数据结构
# Bitmap
位图数据结构是一个以位为单位数组,数组中的每个单元只能存0或者1,数组的下标在 Bitmap 中叫做偏移量。特点是可表达内容少,但是占用空间极低,可以用于
- 统计用户是否在线、是否打卡、是否活跃等
- 设备是否在线
应用
记录用户打卡,1代表打卡,0代表没打卡
127.0.0.1:6379> setbit sign 1 1
(integer) 0
127.0.0.1:6379> setbit sign 2 0
(integer) 0
127.0.0.1:6379> setbit sign 3 1
(integer) 0
2
3
4
5
6
查看某天是否打卡
127.0.0.1:6379> getbit sign 3
(integer) 1
127.0.0.1:6379> getbit sign 5
(integer) 0
2
3
4
统计操作,统计打卡天数
127.0.0.1:6379> bitcount sign # 统计这周的打卡记录,就可以看到是否有全勤!
(integer) 3
2
# geospatial (地理位置)
Redis 在 Redis 3.2 版本推出的数据结构! 这个功能可以推算地理位置的信息: 两地之间的距离, 方圆几里的人
待补充