# 一、主从模式
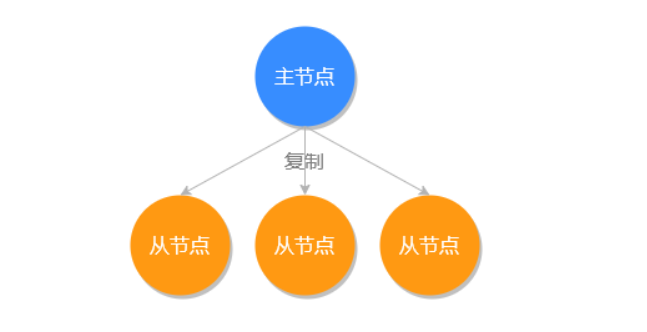
主从模式是一种“读写分离”思想的实现。Redis单机大概能支撑几万的qps,而主从模式可以大大提高其读并发性能,主从模式通常是一主多从,主节点负责写操作和将数据复制到其他从节点,从节点负责读操作,本质上就是读写分离。主从模式下的Redis有以下特点:
- 高并发(读写分离)
- 高可用(主从切换)
- 高可靠(从备份数据)
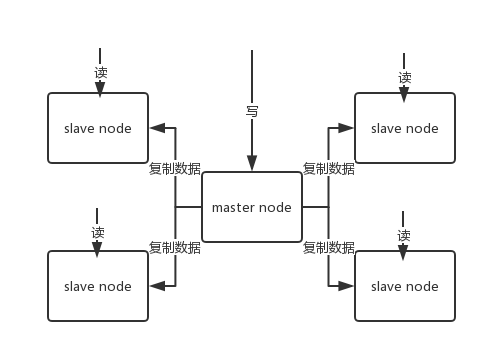
# 1.1 数据同步
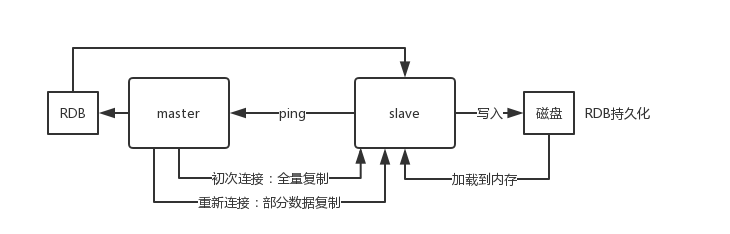
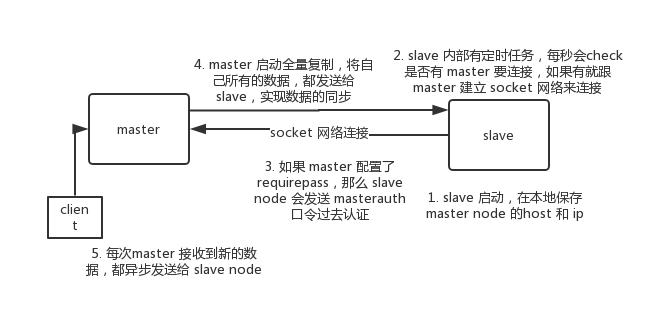
全量复制:当有新的从服务器连接时,为了保障多个数据库的一致性,主服务器会执行一次
bgsave命令生成一个 RDB 文件,然后再以 Socket 的方式发送给从服务器,从服务器收到 RDB 文件之后再把所有的数据加载到自己的程序中,就完成了一次全量的数据同步。增量复制:
2.8之前:从服务器掉线重连后,主服务器都会进行一次完整的数据同步,如果掉线时间比较短,那么这种方式是非常不划算的。
2.8之后:当从服务器掉线后,主服务器会把离线后的写入命令,存储在一个特定大小的队列中,队列可以保证先进先出的顺序,当从服务器重写恢复上线之后,主服务会判断离线这段时间内的命令是否还在队列中,如果在就直接把队列中的数据发送给从服务器,这样就避免了完整同步的资源浪费。
存储离线命令的队列大小默认是 1MB,可以修改队列大小的配置项 repl-backlog-size。
无盘同步:当新的从节点加入时,主服务器会通过bgsave在本地生成RDB文件发送给从服务器,从服务器会先将RDB文件持久化到磁盘再读取,由于磁盘操作非常慢,为了解决这一问题,在2.8.18后增加了无盘复制功能,其特点是RDB文件不需要存入磁盘,而是由子线程生成数据内容通过socket直接发送到从服务器,这样主服务器可以避免磁盘写入与读取的过程,提高同步性能。
无盘复制默认是开闭的,需要通过配置
repl-diskless-sync为yes开启
完整流程
常用命令
replicaof host port:配置从节点replicaof no one:关闭从节点role:查看当前节点角色
# 二、哨兵模式
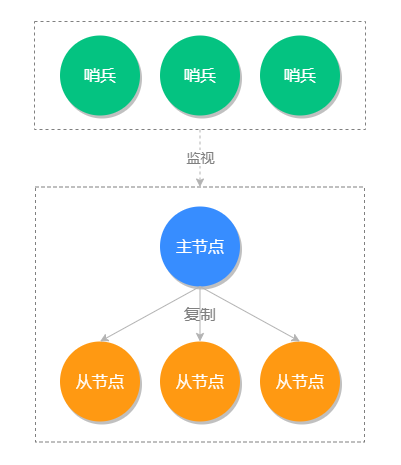
哨兵模式是一种自动容灾技术,可以避免手动切换服务器带来的弊端。Redis的实现方式是搭建一个sentinel集群,通过每秒一次ping命令的频率监听当前的主从模式的节点(默认超过30秒则认为下线),假如当前的sentinel节点有五个,quorum配置为3,那么当超过3个sential节点监测到主节点下线(主观认为),则客观认为主节点掉线,此时会启动故障转移。
# 2.1 自动发现机制
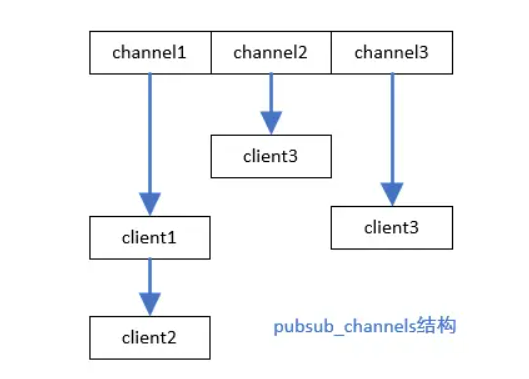
哨兵互相之间的发现,是通过 Redis 的 pub/sub(发布订阅,在redis种pubsub_channels是字典数据结构,key为channel即频道,value为list即订阅的客户端) 系统实现的,每个哨兵都会往 __sentinel__:hello 这个 channel 里发送一个消息,内容是自己的 host、ip 和 runid 还有对这个 master 的监控配置。这时候所有其他哨兵都可以消费到这个消息,并感知到其他的哨兵的存在。
配置传播
哨兵完成切换之后,会在自己本地更新生成最新的 master 配置,然后通过发布订阅模式同步给其他的哨兵。其他的哨兵会根据配置信息的版本号,更新最新版本的master配置信息。
# 2.2 故障转移
主从节点竞选
故障转移即剔除掉线的主节点,从从节点中竞选主节点,竞选过程主要参照以下两个指标:
- 优先级:即节点的权重,可以通过
replica-priority配置,值越小则优先级越高。 - 偏移量:即从节点数据同步情况,偏移量越大则说明数据同步度更高,优先级也越高。
故障转移过程重点有以下步骤:
- 从节点排除
- 排除掉线的从节点
- 排除长时间没有跟主几点通信的从节点
- 排除优先级为0的从节点
- 主节点竞选
- 优先级高的从节点优先
- 优先级一样,则偏移量高的从节点优先
- 优先级和偏移量一样,则选择 Redis 运行时随机生成 ID 最小那个为新的主服务器
- 旧的主节点恢复:会作为新的从节点存在,并且清空数据,同步新的主节点的数据
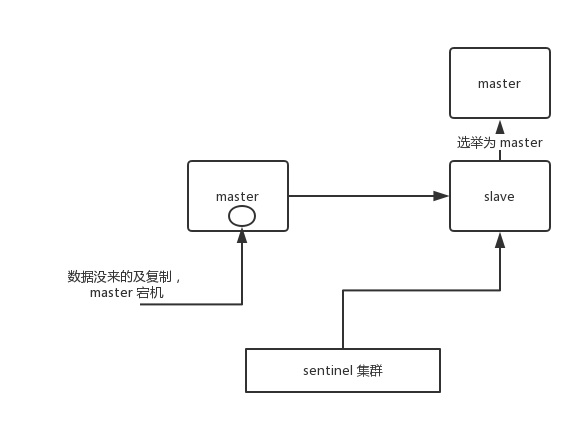
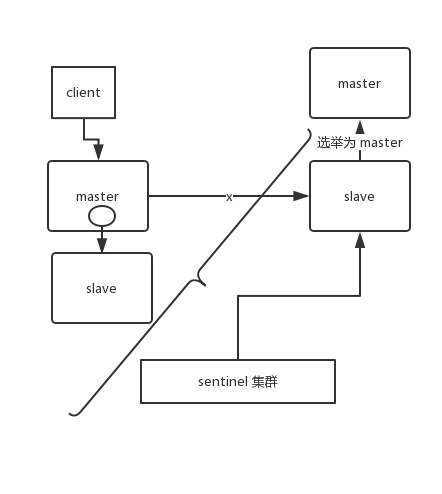
主备切换导致数据丢失
- 异步复制导致数据丢失(宕机)
- 脑裂导致的数据丢失(网络问题)
数据丢失的解决方案
下面配置表示:至少有 1 个 slave,数据复制和同步的延迟不能超过 10 秒。这个配置可以保证主节点超过十秒的数据至少被从节点同步过了,否则主节点拒绝接收写入命令。
// 超过十秒的主数据
min-slaves-max-lag 10
// 至少被同步到一台从服务器上
min-slaves-to-write 1
2
3
4
这个配置可以将上述的两个问题导致的数据丢失都控制在10秒内,也就是保证丢失的数据是可控的。
Sentinel集群搭建
配置
sentinel.conf文件,如监听的master ip、端口和密码sentinel monitor mymaster 127.0.0.1 6379 1 sentinel auth-pass mymaster pwd6543211
2启动sentinel
// 通过以下命令可以启动sentinel,当多个sentinel监听同个master时会相互识别,形成sentinel
./src/redis-sentinel sentinel.conf
1
2
常用命令
- 添加新的sentinel节点到集群:
sentinel monitor master-name ip port quorum - 移除sentinel节点:
sentinel remove mymaster - 修改quorum;
sentinel set master-name quorum n - 查看某主节点的信息:
sentinel master master-name: - 通过主节点名查看其ip和端口号:
sentinel get-master-addr-by-name master-name - 查看某从节点的信息:
sentinel slaves slave-namesentinel replicas slave-name
- 强制故障转移:
sentinel failover master-name
# 三、集群模式
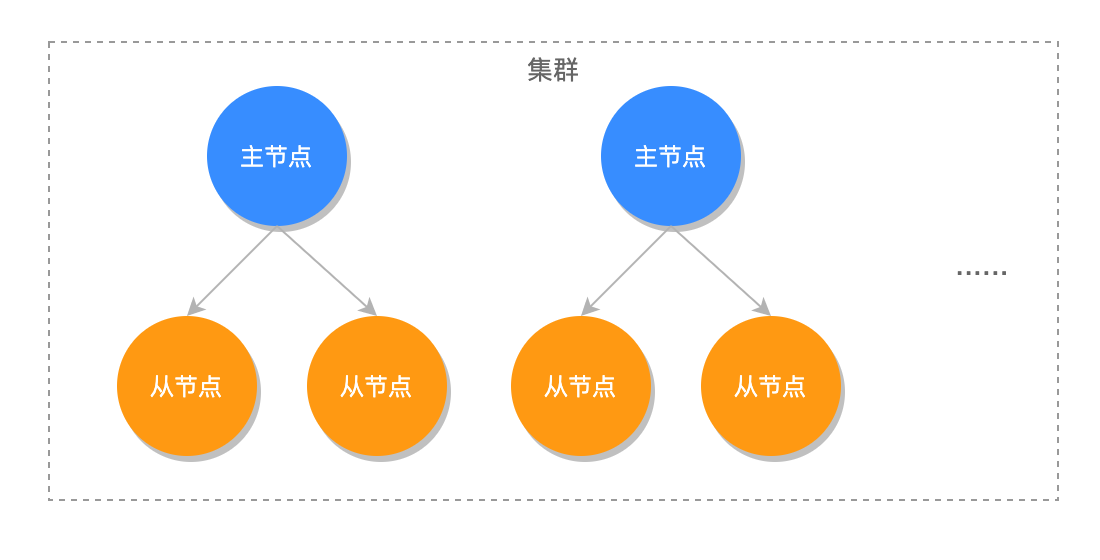
Redis Cluster是3.0后推出的去中心化的集群方案。其通过将数据分为16384个槽分布到不同的服务器上,来降低系统对单主节点的依赖,并且可以大大的提高 Redis 服务的读写性能,主要是针对海量数据+高并发+高可用的场景。其特点是
高读写性能:主节点存在多个,可以多路写入,从节点提供读服务,读写分离。
高可用:部分master不可用时,还是可以继续工作
# 3.1 分布式寻址算法
Hash算法
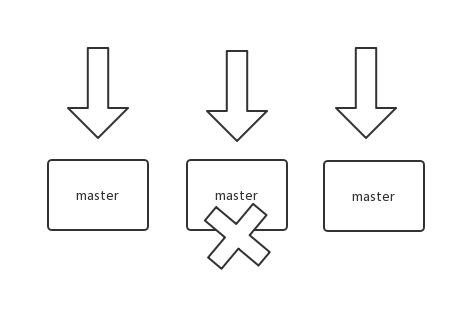
来了一个 key,首先计算 hash 值,然后对节点数取模。然后打在不同的 master 节点上。一旦某一个 master 节点宕机,所有请求过来,都会基于最新的剩余 master 节点数去取模,尝试去取数据。这会导致大部分的请求过来,全部无法拿到有效的缓存,导致大量的流量涌入数据库。
一致性 hash 算法
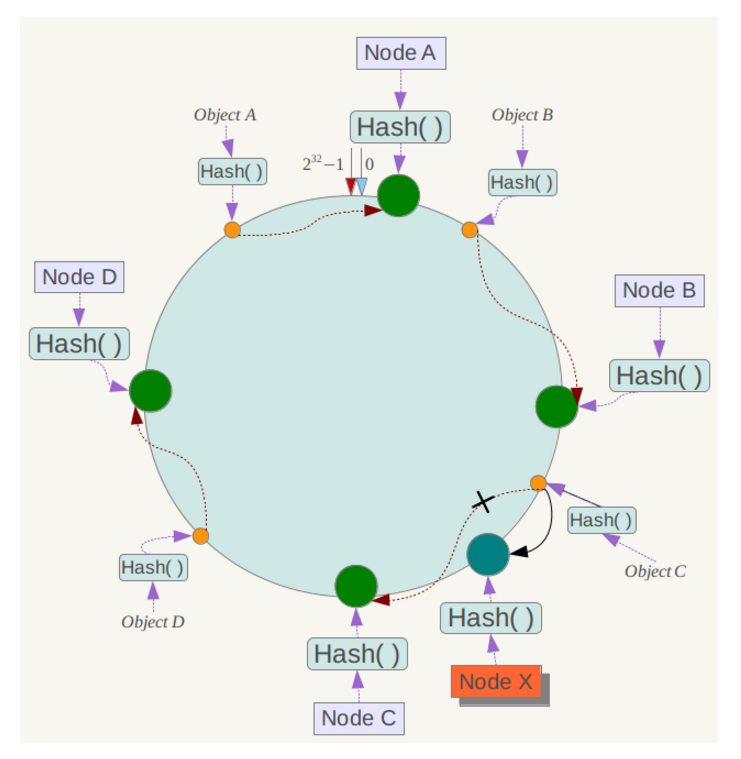
- 将整个hash值空间虚拟成一个环,将master节点进行hash计算其在环上的位置
- 来了一个 key,首先计算 hash 值,并确定此数据在环上的位置,从此位置沿环顺时针“行走”,遇到的第一个 master 节点就是 key 所在位置
- 如果一个节点挂了,那么只会影响这个节点上的部分数据。
一致性hash算法在节点比较少的时候,容易因为节点分布不均匀而造成缓存热点的问题。为了解决这种热点问题,一致性 hash 算法引入了虚拟节点机制,即对每一个节点计算多个 hash,每个计算结果位置都放置一个虚拟节点。这样就实现了数据的均匀分布,负载均衡。
hash slot算法(槽位定位)
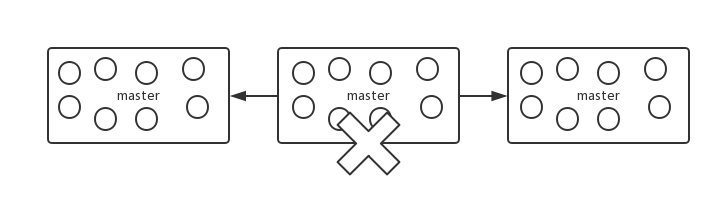
Redis 集群总共的槽位数是 16384 个,每一个主节点负责维护一部分槽以及槽所映射的键值数据,Redis 集群默认会对要存储的 key 值使用 CRC16 算法进行 hash 得到一个整数值,然后用这个整数值对 16384 进行取模来得到具体槽位,公式为:
slot = CRC16(key) % 16383
# 3.2 节点通信机制
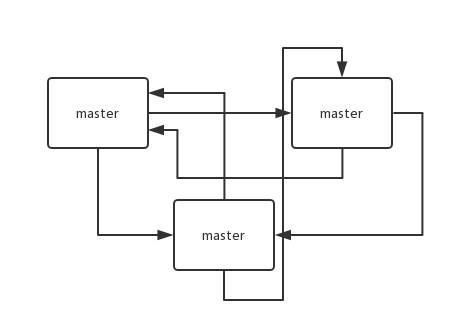
集群元数据的维护有两种方式:集中式、Gossip 协议。Redis cluster 节点间采用 gossip 协议进行通信。集中式是将集群元数据(节点信息、故障等等)集中存储在某个节点上。如Kafka中的zookeeper。
集中式
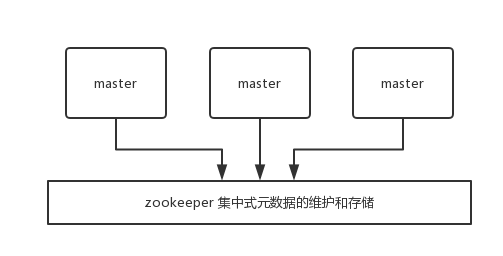
gossip 协议
节点间通过开启10000+当前端口号的端口,用于内部的节点间通信,通过PING、PONG命令监测节点存活以及集群元数据交换,通过MEET命令添加新节点进入集群,当某个节点发现故障节点后,向其他节点发送FAIL命令通知其他节点进行检测和故障确定。
- ping命令深入解析:
- 每个节点会周期性的选择5个最久没有通信的其它节点。如果发现某个节点通信延时达到了
cluster_node_timeout / 2,那么立即发送 ping。 - 每次 ping,会带上自己节点的信息,还有就是带上 1/10 其它节点的信息,发送出去,进行交换。至少包含
3个其它节点的信息,最多包含总节点数减 2个其它节点的信息。
- 每个节点会周期性的选择5个最久没有通信的其它节点。如果发现某个节点通信延时达到了
# 3.3 故障发现转移
故障发现:疑似下线 + 确定下线
正常情况下集群中节点会定期向其他节点发送PING确认其是否在线,如果规定时间内没有收到PONG,该节点会将其标记为疑似下线并向集群广播
其他节点收到广播后会向该节点发送PING,如果超过半数标记为疑似下线,则标记为确认下线并向集群广播
其他节点收到下线广播后,会立即对该节点进行主从切换(故障转移)
故障转移
- 选择节点:从下线的主节点中选择一个从节点(根据新主节点选举原则)
- 切换模式:从节点执行
SLAVEOF NO ONE命令,切换为主节点模式,保留原来同步的数据 - 重派槽点:新的主节点会撤销所有对已下线主节点的槽指派,并将这些槽全部指派给自己
- 通知集群:新的主节点向集群广播一条 PONG 消息,通知其他节点自己已经切换为主节点并且接管了槽位
- 正常处理:新的主节点开始处理相关的命令请求,此故障转移过程完成。
新主节点选举
- 每个主节点都有一票
- 当从节点发现自己正在复制的主节点确认下线之后,就会向集群广播一条消息,要求所有有投票权的主节点给自己投票
- 每个主节点会向第一个要求投票的从节点投票
- 从节点获票数超过主节点数的1/2,则选举成功,从节点晋升为主节点
负载均衡
在 Redis 集群负载不均衡的情况下,我们可以使用 rebalance 命令重新分配各个节点负责的槽数量,从而使得各个节点的负载压力趋于平衡,从而提高 Redis 集群的整体运行效率。
redis-cli --cluster rebalance 127.0.0.1:30007
# 四、集群搭建
# 4.1 主从模式
# 搭建过程
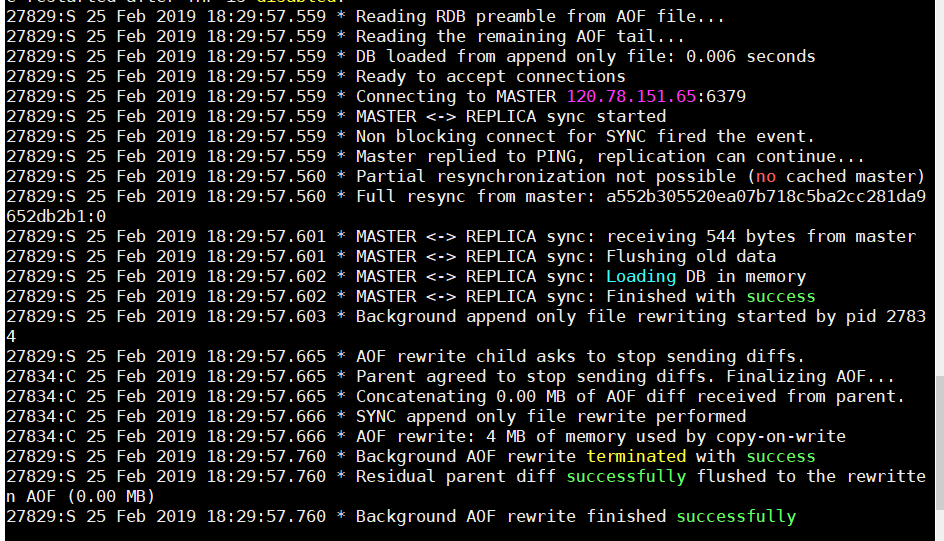
- 修改replica(从者redis)的
redis.conf配置文件(有密码还需要配置replica连接master的密码)
# 设置master的IP及端口
replicaof [masterip] [port]

# replica需要关闭集群的启动模式,否则会报异常
cluster-enable no
2
3
4
5
- 重启replica的redis
进入redis的src目录下,执行
./redis-cli -a [password] -h [ip] -p [port] shutdown关闭redis使用
./redis-server ../redis.conf命令重启redis服务器
# 4.2 集群模式
# 搭建过程
redis集群搭建前提,修改
redis.conf配置文件,找到以下配置信息并做如下图修改: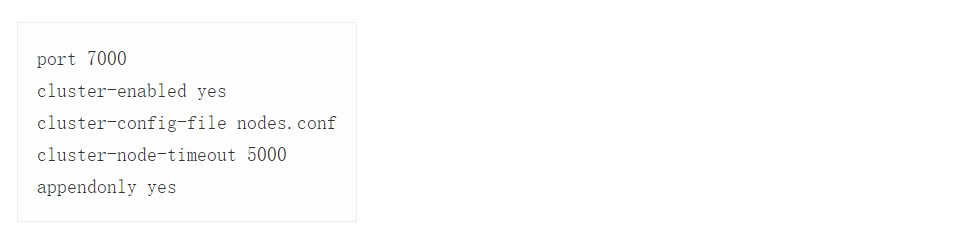
redis集群至少需要开启六个redis节点,复制六个redis文件夹,在配置文件
redis.conf中修改不同的端口号,分别进入src目录,执行命令./redis.server ../redis.conf,带配置文件启动redis。
在阿里云服务器(个人使用的服务器)中开启端口号,如
6379/6384(6379-6384),开启后还需要开启集群总线端口16379/16384(16379-16384),若未开启,在使用公网Ip进行集群搭建的时候会报错。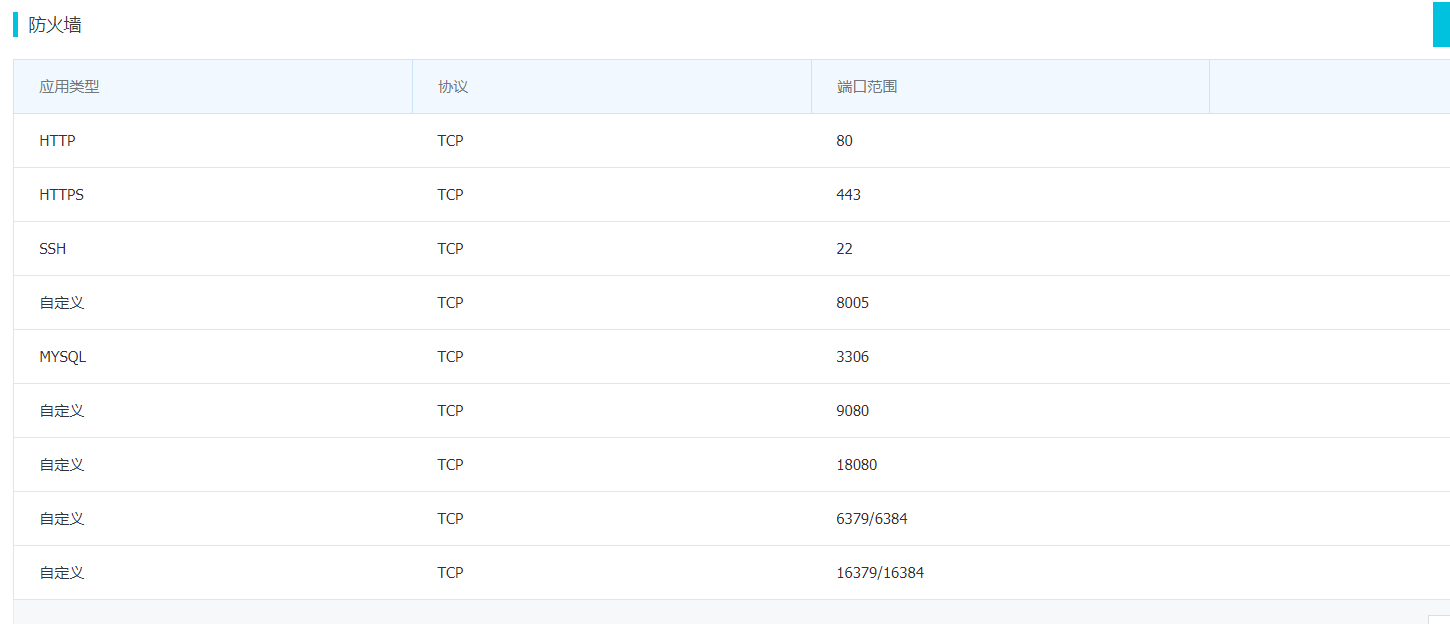
进入其中一个redis的src文件夹中,执行命令
./redis-cli -a password --cluster create xxx.xx.xxx.xx:6379 xxx.xx.xxx.xx:6380 xxx.xx.xxx.xx:6381 xxx.xx.xxx.xx:6382 xxx.xx.xxx.xx:6383 xxx.xx.xxx.xx:6384 --cluster-replicas 1创建集群,出现提示信息,输入yes后没有报异常则创建成功(如果已经创建过集群,需要先将每个redis的src目录下的nodes.conf删除,否则会有异常)。创建成功后,可在redis的src目录下执行命令
./redis-cli -a password --cluster fix xxx.xx.xxx.xx:6379进行检查。(下图表示创建成功)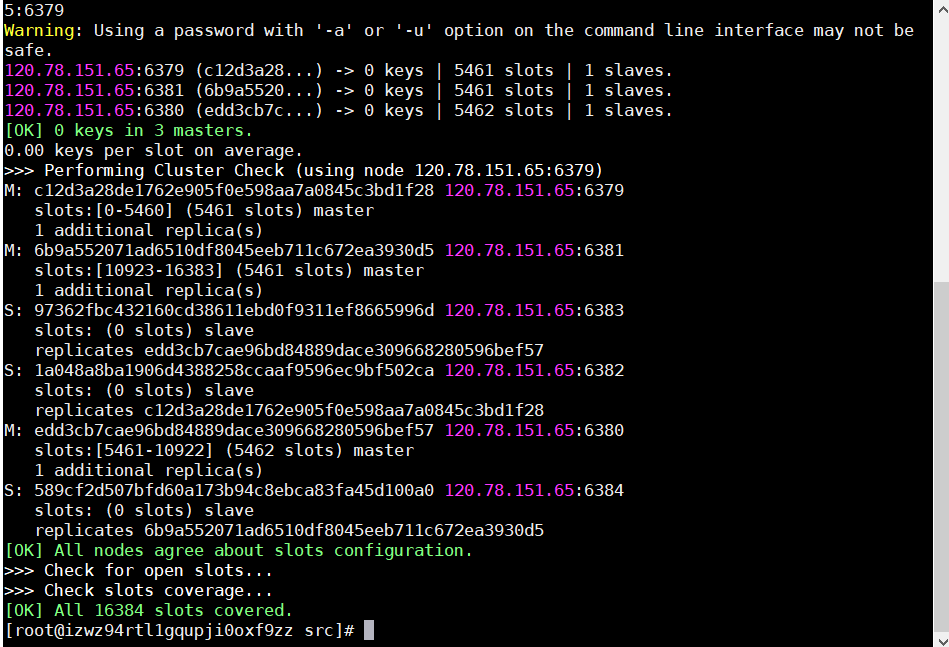
如果是重新创建集群,即使删除
nodes.conf文件后可能创建的集群所有的slot没有被覆盖,需要在其中一个redis的src目录下执行命令./redis-cli -a password --cluster fix xxx.xx.xxx.xx:6379进行修复。
# 异常与解决
SpringBoot使用redis集群出现的异常
SpringBoot连接redis:
- https://blog.csdn.net/lx1309244704/article/details/80696235
- https://www.jianshu.com/p/b75e0d45b5e2
异常1:在SpringBoot进行Redsi集群连接的时候报
ERR This instance has cluster support disabled解决:Redis配置文件没有开启集群模式,在redis.conf中找到
cluster-enabled yes并将其注释去掉。https://blog.csdn.net/z960339491/article/details/80521851异常2:SpringBoot2.x连接redis集群时出现
CLUSTERDOWN The cluster is down或者Node .. is not empty.Either the node already knows other nodes (check with CLUSTER NODES) or contains some key in database 0.,一般出现在创建过集群然后重新创建的时候报的异常解决:需要删除redis的src目录下的
nodes.conf文件,然后重新创建集群。
Linux服务器搭建redis集群时出现的异常
异常1:使用SpringBoot2.x(lettuce redis客户端)整合redis,报异常:
can not connect to 127.0.0.1:6379...,连接不上集群解决:在进行集群创建的时候,使用
./redis-cli -a password --cluster create xxx.xx.xxx.xx:6379 xxx.xx.xxx.xx:6380 xxx.xx.xxx.xx:6381 xxx.xx.xxx.xx:6382 xxx.xx.xxx.xx:6383 xxx.xx.xxx.xx:6384 --cluster-replicas 1进行创建的时候,需要用其公网IP进行创建异常2:进行redis集群创建的时候(公网IP创建),报
Waiting for the cluster to join ...解决:开放其集群通讯端口,如集群使用的是6379-6384,则还需要再开放16379-16384端口,在阿里云防火墙进行开放,否则会一直无法创建--https://blog.csdn.net/Truong/article/details/52531103
异常3:使用
redis-cli --cluster check 127.0.0.1:6379进行集群检查后,检查到[ERR] Not all 16384 slots are covered by nodes.(可能出现在集群有所更换之后)解决:在redis的src目录下运行
./redis-cli -a password --cluster fix 172.168.63.201:7001--https://blog.csdn.net/vtopqx/article/details/50235891 (redis5.0后使用redis-cli --cluster check 127.0.0.1:6379等)异常4:配置从节点redis的
redis.conf文件的replicaof指令后创建集群,报replicaof directive not allowed in cluster mode异常解决:如果是创建集群的话,需要注释掉
replicaof的配置(本人为replica配置处配置了redis密码,这似乎使得主从复制成功了)
参考文献