# 一、管道(Pipeline)
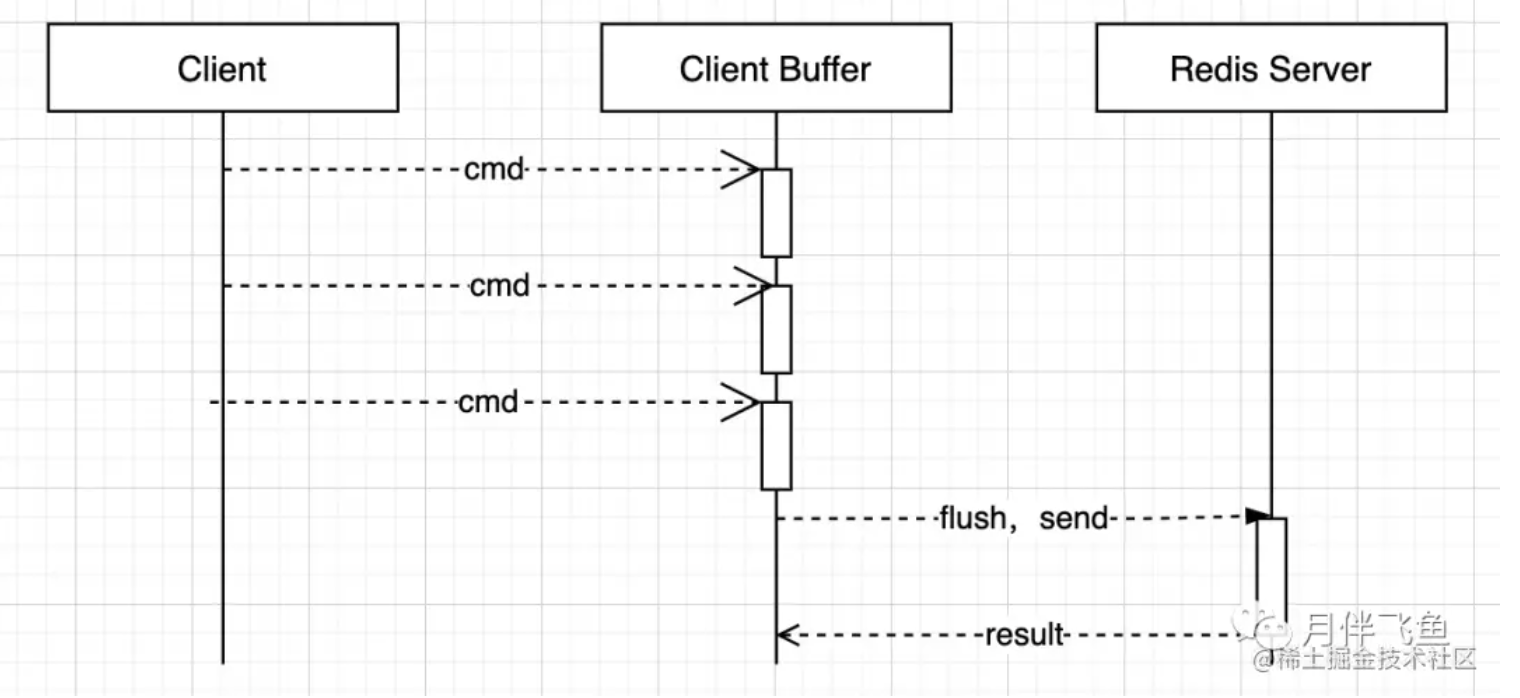
管道技术(Pipeline)本质上就是一种批处理技术。由于客户端与服务端通过socket进行连接,当短时间内大量命令产生的时候,如果采用普通的传输方式进行请求,命令间需要同步调用、请求的往返需要时间,并且客户端和服务端需要多次进行IO的的用户态到内核台的切换,会造成大量的网络资源浪费,而管道技术就是将所有命令都整合起来一次性发给服务端,再一次性响应给客户端,从而大大提升redis的响应速度。管道虽然提升了响应速度,但是仍然需要注意管道传输的数据大小,redis的输入缓冲区默认的最大是1G,超过会被断开连接。
pipeline和原生批量命令(mget、mset)的区别
- 原生命令具有原子性(跟setnx原子性命令类似),pipeline不具备原子性(中间命令出错仍然会继续执行)。
- 原生命令是一个命令对应多个键值对,而pipeline是多条命令。
- 原生命令是服务端实现,而pipeline是服务端和客户端共同完成。(pipeline需要在客户端缓冲区中组装多条指令)
pipeline和事务的区别
事物关注的是ACID,而pipeline关注的是RTT的减少
Redis的事物通过Multi、Exec命令控制,先Multi开启事物,此过程的命令会被存储在队列中,然后在通过exec提交事物
- 原子性:不保证,执行过程有命令出错,仍然会继续执行,但是如果是在执行前检测到命令有误,则会回滚事物
- 隔离性:保证,Redis的事物有CAS(check and set)机制,通过watch机制监控相关key数据是否被修改,修改则关闭事物
- 持久性:不保证,没来得及被持久化的数据,仍然会丢失
pipeline的优缺点
- 优点:批量操作,减少传输IO及系统切换开销
- 缺点:
- 不能保证原子性,部分指令可能执行失败,并且其他指令会继续执行。
- 只能作用在一个节点上,暂时不支持集群。
适用场景
- pipeline适用于指令间没有依赖关系的情况,并且对可靠性要求不高的场景。因为其不能保证所有命令都正常执行。
- 例如用户群发短信,这时候就可以用pipeline,因为群发消息实时性要求不高,并且即使部分失败,后续有补偿机制即可。
pipeline用法
- redistemplate
List<Long> List = redisTemplate.executePipelined(new RedisCallback<Long>() {
  @Nullable
  @Override
  public Long doInRedis(RedisConnection connection) throws DataAccessException {
    connection.openPipeline();
    for (int i = 0; i < 1000000; i++) {
      String key = "123" + i;
      connection.zCount(key.getBytes(), 0,Integer.MAX_VALUE);
    }
    return null;
  }
});
2
3
4
5
6
7
8
9
10
11
12
- Jedis
Jedis jedis = new Jedis("127.0.0.1", 6379);
// 获取 Pipeline 对象
Pipeline pipe = jedis.pipelined();
// 设置多个 Redis 命令
for (int i = 0; i < 100; i++) {
  pipe.set("key" + i, "val" + i);
}
// 执行命令并返回结果
List<Object> res = pipe.syncAndReturnAll();
for (Object obj : res) {
  // 打印结果
  System.out.println(obj);
}
2
3
4
5
6
7
8
9
10
11
12
13
# 二、持久化(AOF/RDB)
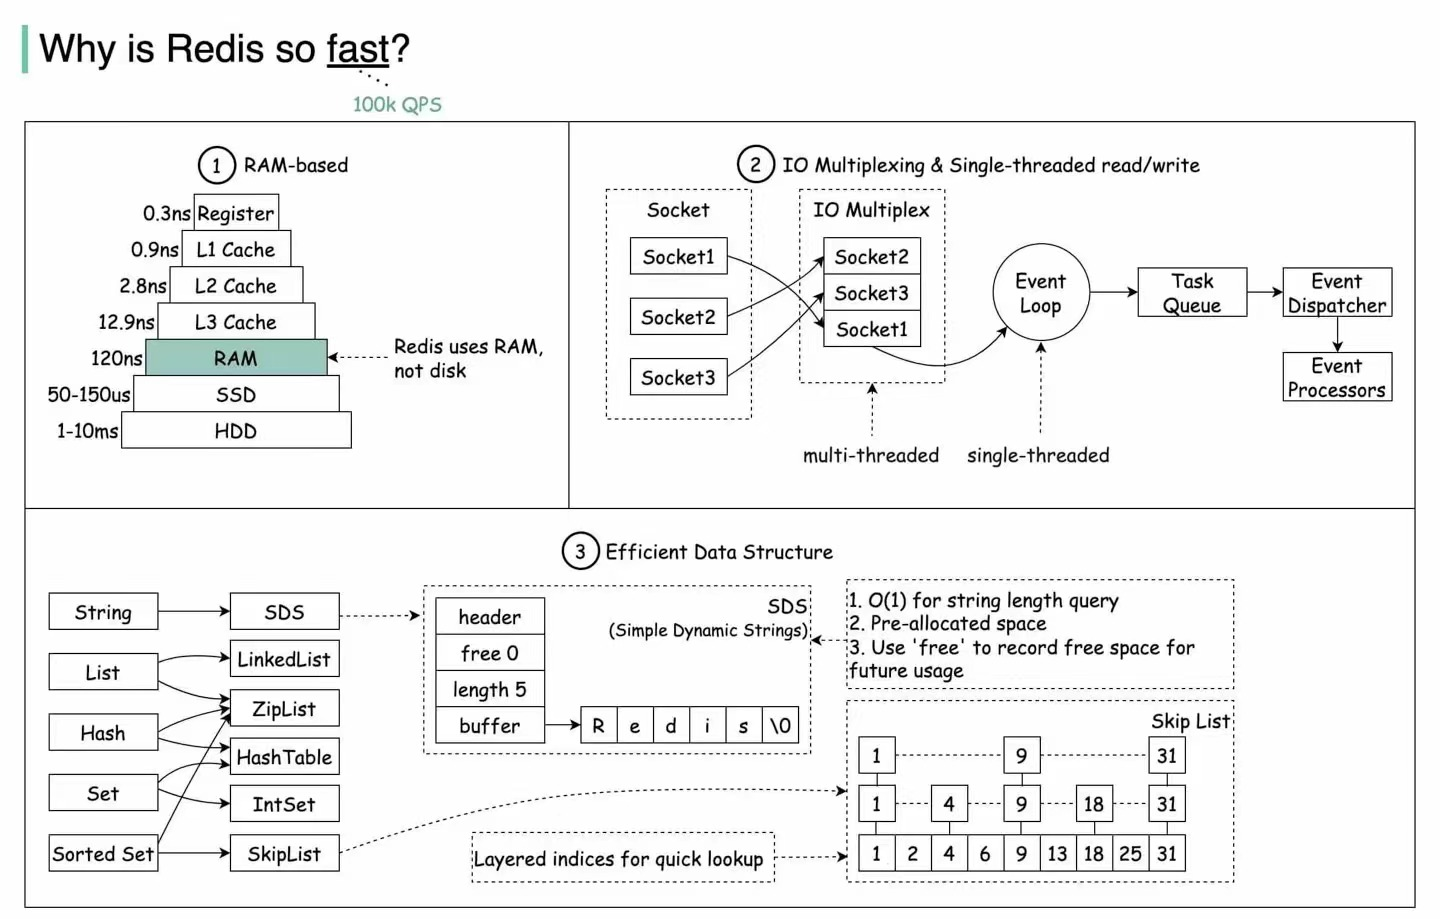
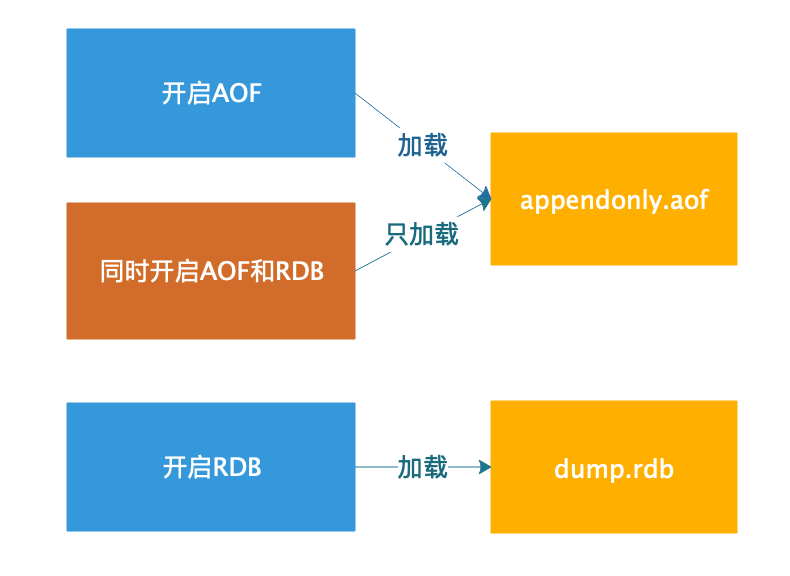
由于Redis在内存中做数据操作,为了保证服务器重启时数据不丢失,Redis提供了两种持久化机制(Redis的持久化过程都是通过fork新的线程异步执行),分别为AOF(appendonly.aof)和RDB(dump.rdb),两者的区别如下:
- 文件格式不同:AOF存储的是键值操作的命令,以文件追加的方式添加到AOF文件中,所以文件会比较大。而RDB存储的是某时刻的内存快照,将当前数据以二进制文件存储并写入磁盘,相对文件比较小。
- AOF文件恢复速度比较慢,但是可读性好,容易修复,而且增量的方式更加轻量。
- RDB文件则恢复速度快,但是每次都需要持久化整块内存快照,所以在数据量较大而且CPU性能不佳时会导致服务停顿。
- 持久化时间不同:AOF默认每秒将命令追加到AOF文件中,即使服务重启也只会丢失一秒内的操作,而RDB由于是对内存快照的复制,不能像AOF那样进行增量增加,所以通常是隔一段时间进行持久化存储,这就导致RDB模式下容易丢失某段时间内的数据。
- 恢复程度不同:如果不小心调用了flushall命令,由于AOF是文件追加方式,可以通过删除flushall命令还原,而RDB是基于内存快照,会导致所有数据被清空。
AOF和RDB除了自动触发外,也可以通过手动触发:
- save:同步持久化,阻塞主线程
- bgsave:异步持久化,通过fork命令创建子线程,而fork也会消耗一定的内存
AOF重写机制
由于AOF以文件追加方式添加到AOF文档,为了解决文档过大的问题,Redis提供了文件重写功能,当达到一定的文件大小(默认为60M),则重写当前文件,并把当前数据的最少操作命令保存到新文件上,从而减少文件大小。
AOF和RDB混合持久化
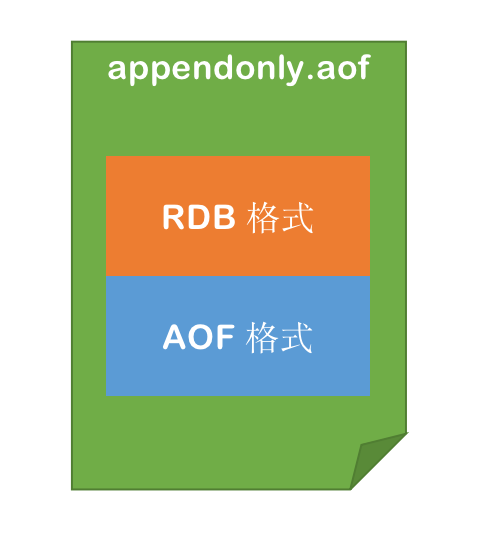
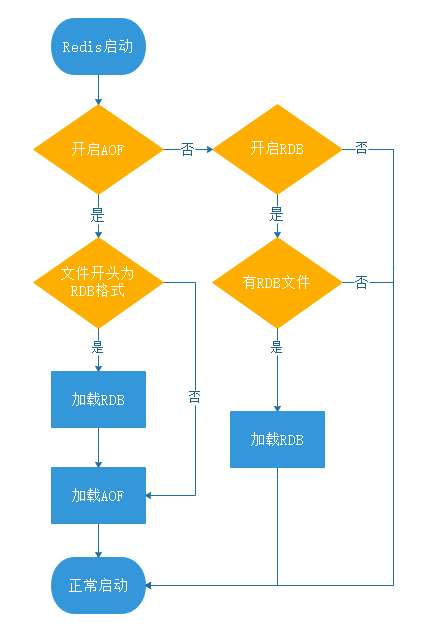
由于AOF和RDB各有弊端,AOF文件过大时会影响启动速度,RDB会有一段时间的数据丢失,为了同时能用到AOF和RDB的优点,Redis4.0后新增了混合持久化的方式,在混合持久化的模式下,AOF在重写时会把Redis的持久化数据,以RDB的格式进行存储,并且将接下来的持久化以AOF格式追加到文件末尾。开头为RDB文件,使得Redis能够快速启动,同时又结合了AOF的优点,避免了大量数据丢失的风险。
# 三、事务
Redis的事务底层通过
MULTI(开启事务) 、 EXEC (执行)、 DISCARD(回滚) 和 WATCH(监听)几个命令实现。事务衡量指标是ACID,Redis中的事务保证如下:
A原子性:编译时保证原子性,如果编译时发现中间有命令语法错误,则回滚;运行时不保证,运行中有命令出错则跳过继续执行。Redis只保证所有的命令,要么全部执行,要么全部不执行。而不是完全成功。(Redis官方认为的原子性)
C一致性:如果按照官方对A的理解,那么一致性也是保证的。
I隔离性:Redis事务是严格遵守隔离性的,因为redis是单线程模式,可以保证命令执行过程中不会被其他客户端命令打断。
D持久性:Redis是基于内存进行数据操作的,虽然有持久化机制,但是无法保证所有数据不丢失。
CAS操作实现乐观锁
案例分析:
用户1先读key,后操作,再写入
用户2先读key,后操作,再写入
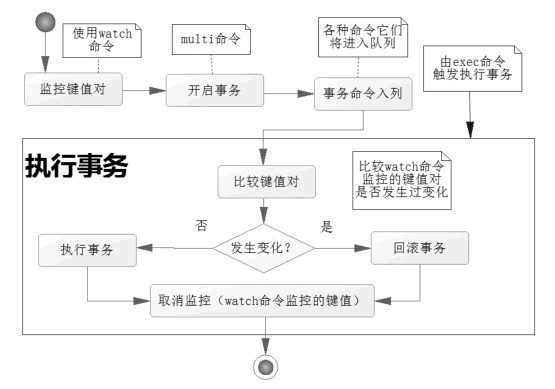
这会出现并发问题,导致数据被覆盖,Redis提供了watch命令实现CAS操作,通过watch监控某个键值对,然后开启事务进行修改,如果在提交事务前发现键值对被修改了,则回滚事务。
WATCH mykey
MULTI
val = GET mykey
val = val + 1
SET mykey $val
EXEC
1
2
3
4
5
6
Redis事务执行步骤
- 开启:以MULTI开始一个事务
- 入队:将多个命令入队到事务中,接到这些命令并不会立即执行,而是放到等待执行的事务队列里面
- 执行:由EXEC命令触发事务
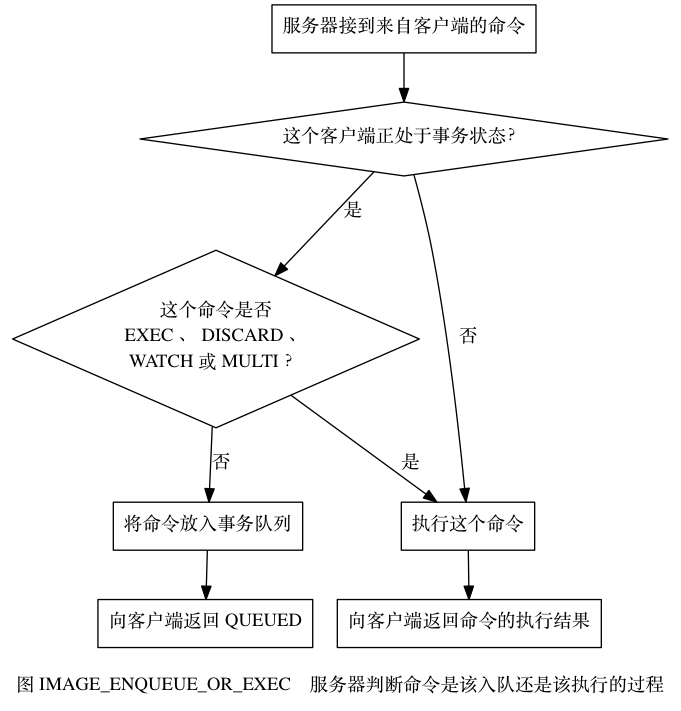
当一个客户端切换到事务状态之后, 服务器会根据这个客户端发来的不同命令执行不同的操作:
- 如果客户端发送的命令为 EXEC 、 DISCARD 、 WATCH 、 MULTI 四个命令的其中一个, 那么服务器立即执行这个命令。
- 与此相反, 如果客户端发送的命令是 EXEC 、 DISCARD 、 WATCH 、 MULTI 四个命令以外的其他命令, 那么服务器并不立即执行这个命令, 而是将这个命令放入一个事务队列里面, 然后向客户端返回 QUEUED 回复。