# 一、强一致性
# 1.1 Paxios
Paxos算法是Lamport宗师提出的一种基于消息传递的分布式一致性算法,使其获得2013年图灵奖。
Paxos将系统中的角色分为提议者 (Proposer),决策者 (Acceptor),和最终决策学习者 (Learner)(可以理解为人大代表(Proposer)在人大向其它代表(Acceptors)提案,通过后让老百姓(Learner)落实)
Proposer: 提出提案 (Proposal)。Proposal信息包括提案编号 (Proposal ID) 和提议的值 (Value)。Acceptor: 参与决策,回应Proposers的提案。收到Proposal后可以接受提案,若Proposal获得多数Acceptors的接受,则称该Proposal被批准。Learner: 不参与决策,从Proposers/Acceptors学习最新达成一致的提案(Value)。
在多副本状态机中,每个副本同时具有Proposer、Acceptor、Learner三种角色。
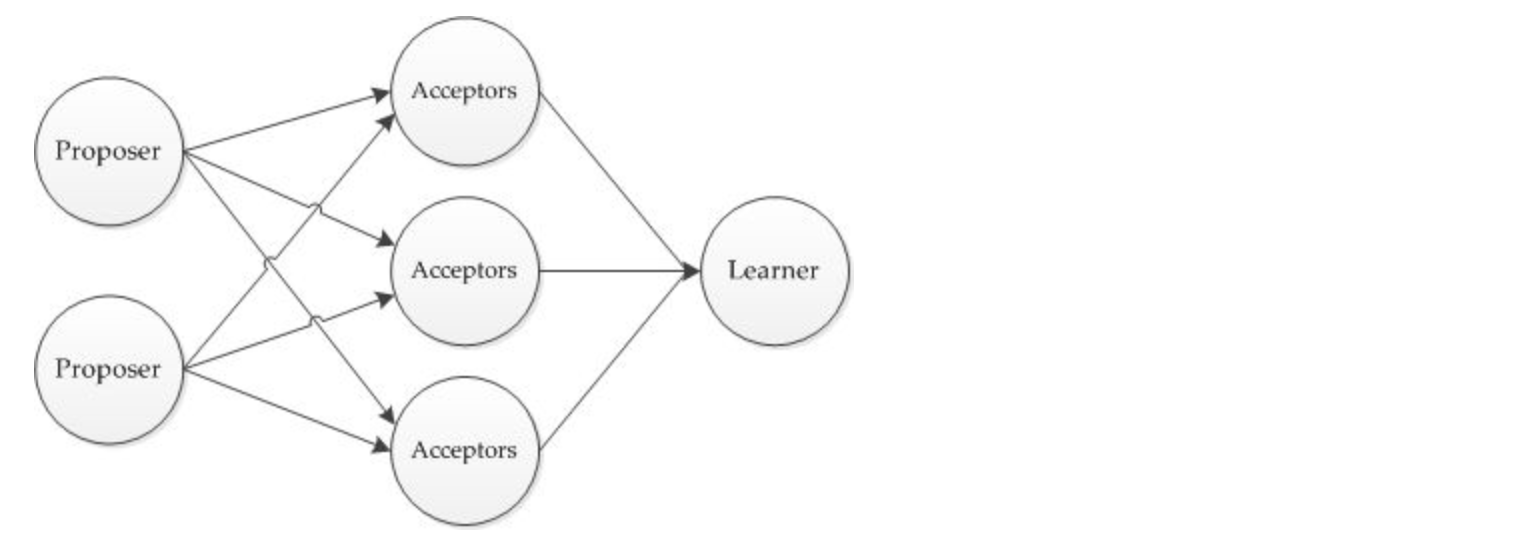
- 基于消息传递的3个阶段
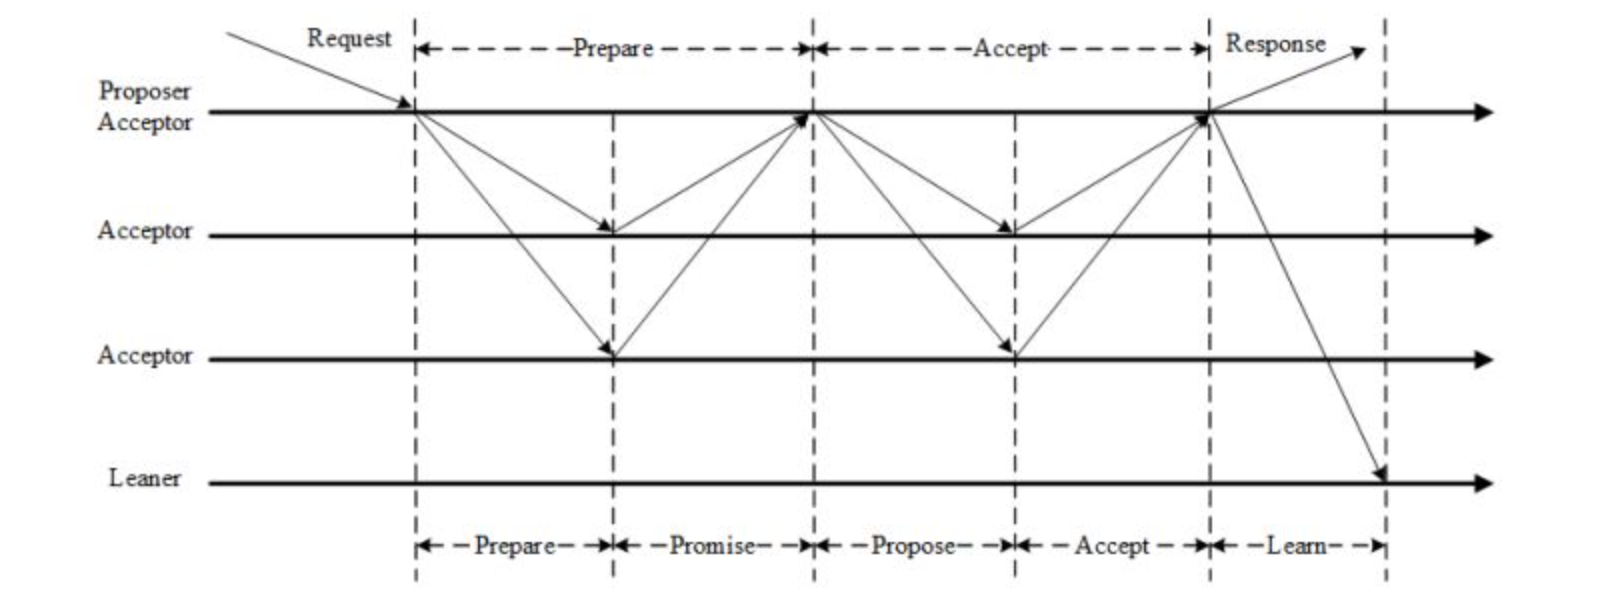
第一阶段: Prepare阶段
Proposer向Acceptors发出Prepare请求,Acceptors针对收到的Prepare请求进行Promise承诺。
Prepare: Proposer生成全局唯一且递增的Proposal ID (可使用时间戳加Server ID),向所有Acceptors发送Prepare请求,这里无需携带提案内容,只携带Proposal ID即可。Promise: Acceptors收到Prepare请求后,做出“两个承诺,一个应答”。- 承诺1: 不再接受Proposal ID小于等于(注意: 这里是<= )当前请求的Prepare请求;
- 承诺2: 不再接受Proposal ID小于(注意: 这里是< )当前请求的Propose请求;
- 应答: 不违背以前作出的承诺下,回复已经Accept过的提案中Proposal ID最大的那个提案的Value和Proposal ID,没有则返回空值。
第二阶段: Accept阶段
Proposer收到多数Acceptors承诺的Promise后,向Acceptors发出Propose请求,Acceptors针对收到的Propose请求进行Accept处理。
Propose: Proposer 收到多数Acceptors的Promise应答后,从应答中选择Proposal ID最大的提案的Value,作为本次要发起的提案。如果所有应答的提案Value均为空值,则可以自己随意决定提案Value。然后携带当前Proposal ID,向所有Acceptors发送Propose请求。Accept: Acceptor收到Propose请求后,在不违背自己之前作出的承诺下,接受并持久化当前Proposal ID和提案Value。
第三阶段: Learn阶段; Proposer在收到多数Acceptors的Accept之后,标志着本次Accept成功,决议形成,将形成的决议发送给所有Learners。
# 1.2 Raft
Todo
# 1.3 ZAB
ZAB 协议全称:Zookeeper Atomic Broadcast(Zookeeper 原子广播协议)
ZAB是用于解决Zookeeper集群的分布式一致性问题的算法,常见的分布式一致性算法有Paxios和Raft,而Zookeeper采用ZAB协议解决。ZAB为Zookeeper提供了**
崩溃恢复和原子广播**功能。Zookeeper为了避免单点故障问题,通常是以集群的方式存在的,其采用了主从模式,一主多从。
消息广播(数据一致性):主从节点间则涉及到数据同步问题,同步过程数据可能丢失,也可能处理失败,ZAB协议则保证了其主从节点数据的一致性。
崩溃恢复(集群高可用性):主节点可能会宕机崩溃,为了保证Zookeeper的高可用性,需要进行故障转移,选举新的主节点,Zookeeper通过ZAB协议的崩溃恢复实现。
# 消息广播
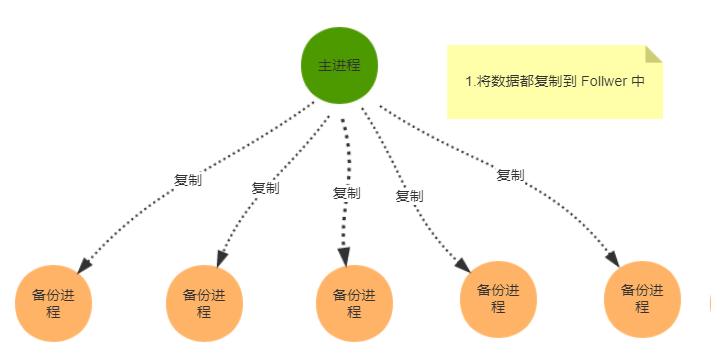
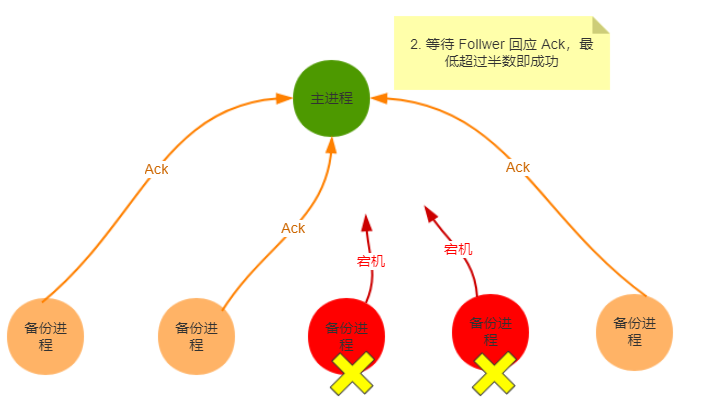
ZAB 协议的消息广播过程使用的是一个原子广播协议,类似一个 二阶段提交过程。对于客户端发送的写请求,全部由 Leader 接收,Leader 将请求封装成一个事务 Proposal,将其发送给所有 Follwer ,然后,根据所有 Follwer 的反馈,如果超过半数成功响应,则执行 commit 操作(先提交自己,再发送 commit 给所有 Follwer)。
基本上,整个广播流程分为 3 步骤:
- 复制Leader数据到 Follwer
- 等待 Follwer 回应 Ack,最低超过半数即成功
- 当超过半数成功回应,则执行 commit ,同时提交自己
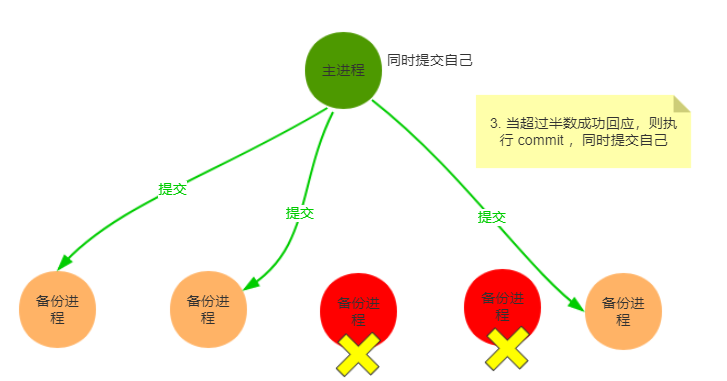
(实际上,在 Leader 和 Follwer 之间还有一个消息队列,用来解耦他们之间的耦合,避免同步,实现异步解耦。)
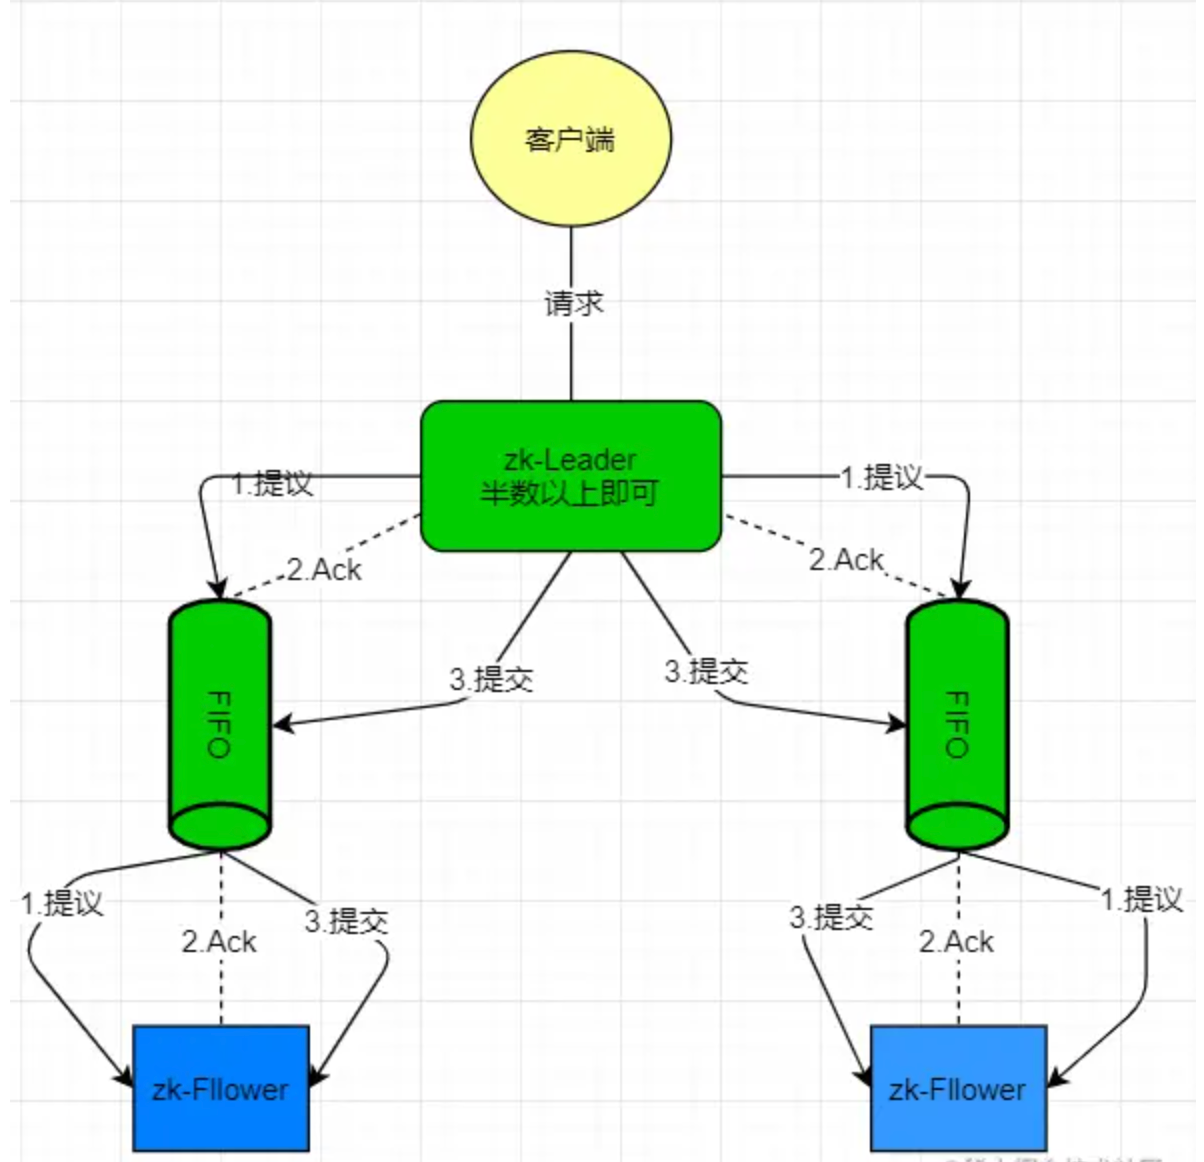
通过以上 3 个步骤,就能够保持集群之间数据的一致性。从上面的处理流程看,这就是个简化版的2PC(分布式事务算法)第一阶段做资源处理,第二阶段根据处理情况决定提交或回滚,有区别的是2PC第一阶段是做资源锁定,第二阶段需要等待所有节点都回复ack才提交,而ZAB则只需要保证半数以上的从节点提交了ack即可,因为此处的从节点只是提供了数据备份作用则只需要绝大多数同步成功即可,而2PC的应用场景通常是多库的插入,需要保证所有数据都插入成功。
还有一些细节:
- Leader 在收到客户端请求之后,会将这个请求封装成一个事务,并给这个事务分配一个全局递增的唯一 ID,称为事务ID(ZXID),ZAB 兮协议需要保证事务的顺序,因此必须将每一个事务按照 ZXID 进行先后排序然后处理。
- 在 Leader 和 Follwer 之间还有一个消息队列,用来解耦他们之间的耦合,解除同步阻塞。
- zookeeper集群中为保证任何所有进程能够有序的顺序执行,只能是 Leader 服务器接受写请求,即使是 Follower 服务器接受到客户端的请求,也会转发到 Leader 服务器进行处理。
# 崩溃恢复
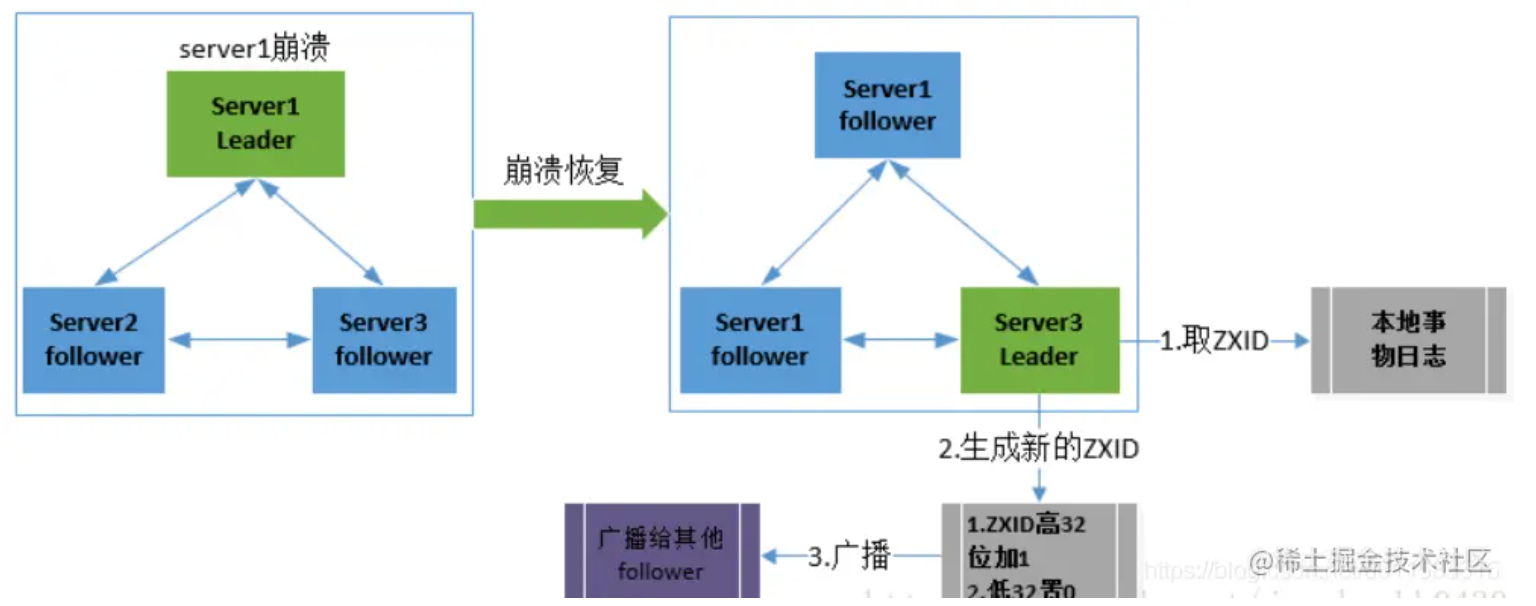
上面的消息广播在leader节点正常运行的时候是可以保证数据一致性的,那么在leader节点崩溃宕机的时候如何保证数据一致呢?Leader崩溃可能发现在以下两个时间:
- 假设1:Leader 在复制数据给所有 Follwer 之后崩溃
- 假设2:Leader 在收到 Ack 并提交了自己,同时发送了部分 commit 出去之后崩溃
Zookeeper通过ZAB协议的崩溃恢复机制保证,其定义了 2 个原则:
- ZAB 协议确保那些已经在 Leader 提交的事务最终会被所有服务器提交(保证提交Leader提交的事务)
- ZAB 协议确保丢弃那些只在 Leader 提出/复制,但没有提交的事务(保证丢弃Leader未提交的事务)
所以,ZAB 设计了下面这样一个选举算法:能够确保提交已经被 Leader 提交的事务,同时丢弃已经被跳过的事务。
针对这个要求,如果让 Leader 选举算法能够保证新选举出来的 Leader 服务器拥有集群总所有机器编号(即 ZXID 最大)的事务,那么就能够保证这个新选举出来的 Leader 一定具有所有已经提交的提案。
简单来说就是每个节点都会保留其当前提交的最大事务Id,Zookeeper会选择事务Id最大的那个节点作为Leader节点(个人认为数据仍然无法保证100%不丢失,是中一种尽可能保证数据不丢失的策略)。
而且这么做有一个好处是:可以省去 Leader 服务器检查事务的提交和丢弃工作的这一步操作。
# 数据同步
当崩溃恢复之后,则需要进行数据的同步,根据崩溃恢复的策略,当Follower 链接上 Leader 之后,Leader 服务器会根据自己服务器上最后被提交的 ZXID 和 Follower 上的 ZXID 进行比对,比对结果要么回滚,要么和 Leader 同步。 当所有的 Follwer 服务器都成功同步之后,Leader 会将这些服务器加入到可用服务器列表中(可认为是ISR列表)。
# 总结
ZAB协议为分布式一致性协议,其提供了消息广播、崩溃恢复机制,Zookeeper基于ZAB实现数据的一致性。
- 消息广播:简易版2PC模式,两段式处理确保主从节点间的数据一致性
- 崩溃恢复机制:通过ZXID(事务ID),选举Leader节点,并比较主从节点间的ZXID确定其数据同步或回滚
# 二、最终一致性
# 消息队列 + Exception Queue
基于消息队列进行数据通信,不要求立刻执行业务并响应执行结果,而是由MQ传输。
开启MQ可靠传输:确保消息从生产者 -> MQ -> 消费者间的可靠传输。
Exception Queue:当业务执行过程异常时,将消息发送至Exception Queue,由异常队列继续重试,确保数据的最终一致性。
# 消息队列 + 本地消息表
当消息进入业务系统时,通过创建消息表,保存消息并预留执行结果的字段,由业务执行完成后回调更新该执行结果的字段。开启定时扫描,如果扫描时发现结果未更新,则重新发送,执行更新成功。
此种机制可能导致重复消费问题,所以需要在业务层做幂等性处理。